TikTok est une mine de données : profils, hashtags, statistiques de vidéos, commentaires. Le web scraping te permet d’extraire tout ça automatiquement. Deux approches s’offrent à toi : utiliser un outil clé en main (sans code) ou coder ton propre scraper en Python.
Voici comment faire, méthode par méthode, avec les données que tu peux récupérer et ce que dit la loi.

Les différentes méthodes pour faire du scraping sur TikTok
Pour scraper TikTok, deux grandes approches existent. Le choix dépend de tes compétences techniques et de la complexité de ton projet.
- Utiliser des outils dédiés (sans code).
- Coder ton propre scraper en Python.
1. Utiliser des outils de web scraping
C’est l’approche la plus simple et rapide, idéale si tu n’as aucune compétence en programmation. Ces outils offrent des solutions clés en main et gèrent à ta place les défis techniques : contournement des protections anti-bot, rotation des proxies, gestion des sessions.
Voici trois scrapers TikTok efficaces :
- Bright Data
- Apify
- Octoparse
Bright Data
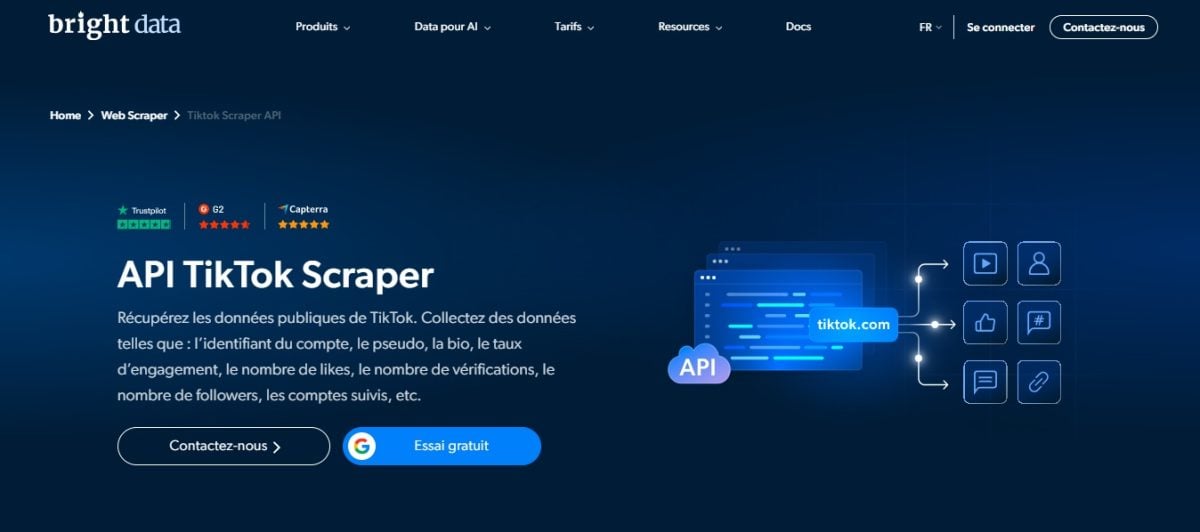
Bright Data est une solution complète, reconnue pour ses services de proxies (résidentiels et mobiles) et ses outils de scraping avancés : API dédiées, navigateur de scraping intégré. Son TikTok Scraper collecte des données sur les profils, les posts (hashtags inclus) et les commentaires. Les résultats sont exportables en JSON ou en CSV pour tes analyses.
C’est le meilleur choix quand ton projet demande beaucoup de volume et une infrastructure fiable. On t’en parle en détail dans notre avis complet sur Bright Data.
Apify

Apify est une plateforme cloud de développement de scrapers capable d’exécuter des extractions à grande échelle.
Son TikTok Scraper récupère des informations détaillées : profils utilisateurs, hashtags, musique associée aux vidéos et métadonnées complètes des posts. Les commentaires s’extraient avec un acteur dédié, le TikTok Comments Scraper.
C’est la solution la plus flexible, idéale quand tu veux personnaliser tes extractions ou automatiser des tâches récurrentes dans le cloud. Les données sont exportées en JSON ou CSV directement depuis l’interface. Pour plus de détails, consulte notre avis complet sur Apify.
Octoparse
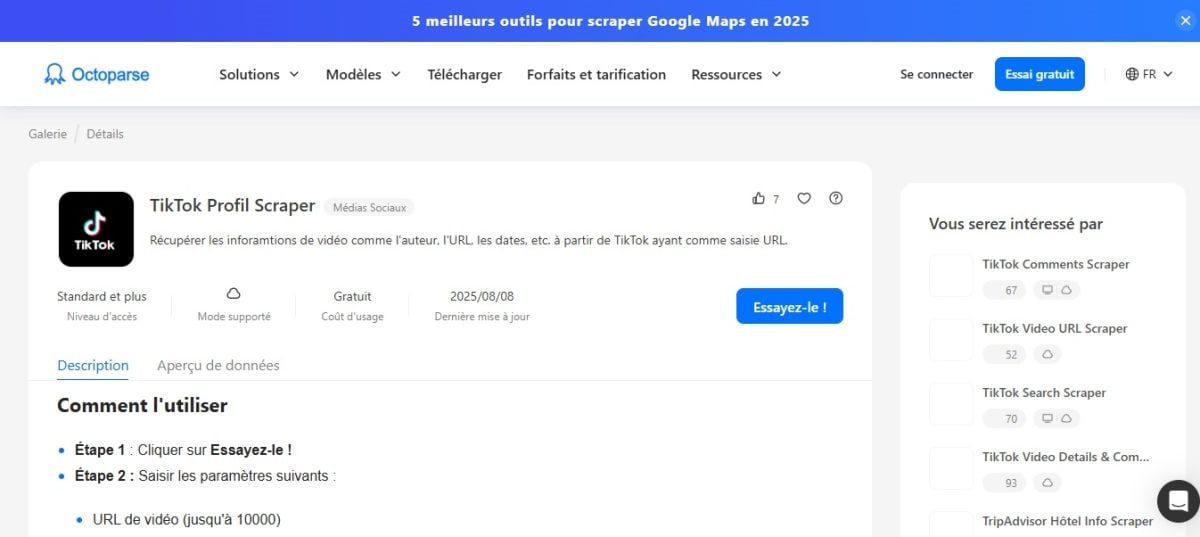
Octoparse est une solution no-code dont l’interface visuelle te permet de créer un scraper en quelques clics, sans écrire une seule ligne de code. L’outil propose aussi un template TikTok Scraper prêt à l’emploi, que tu peux ensuite personnaliser selon tes besoins.
C’est l’option la plus accessible pour un débutant qui veut extraire des données rapidement. Pour en savoir plus, lis notre avis complet sur Octoparse.
2. Faire du scraping par code avec Python
Le scraping avec Python est une approche plus technique et personnalisable, qui demande des bases en programmation. C’est la solution idéale si tu veux un contrôle total sur les données à extraire, les formats de sortie (JSON, CSV) et le rythme des requêtes. Voici comment procéder, étape par étape.
Prérequis
Pour commencer, installe quelques bibliothèques Python :
pip install requests parsel jmespath selenium scrapfly-sdk
Cette commande installe :
- Requests pour les requêtes HTTP.
- Parsel pour analyser le contenu HTML (sélecteurs XPath).
- JMESPath pour filtrer le JSON.
- Selenium pour gérer les pages JavaScript si besoin.
- scrapfly-sdk, le SDK de ScrapFly (service payant, avec 1 000 crédits gratuits pour tester), utilisé plus bas pour gérer l’anti-bot et les proxies.
La méthode utilisée ici repose sur l’extraction des données d’un profil ou d’une vidéo via l’analyse du JSON caché dans la page TikTok.
TikTok injecte ces données directement dans le HTML de la page, dans une balise <script>, ce qui évite d’avoir à appeler une API officielle.
Étape 1 : analyser la requête réseau
- Ouvre les outils de développement (F12) de ton navigateur.
- Dans l’onglet Network, observe les requêtes chargées quand tu visites un profil ou une vidéo sur tiktok.com.
- Repère la source des données. Pour un profil ou une vidéo, c’est la balise <script id= »__UNIVERSAL_DATA_FOR_REHYDRATION__ »>, visible dans le code source de la page (onglet Elements). Pour les commentaires, ce sont des requêtes XHR vers une URL du type /api/comment/list/, visibles dans l’onglet Network. Leur URL complète figure dans l’onglet Headers.
- Pour un profil ou une vidéo, tu utiliseras simplement l’URL de la page ; pour les commentaires, l’URL de l’endpoint.
Étape 2 : envoyer la requête et obtenir la réponse
Une fois la source identifiée, utilise Python pour requêter la page et extraire le JSON qu’elle contient.
import requests
from parsel import Selector
import json

url = "https://www.tiktok.com/@pseudo"  # remplace par l'URL visée
resp = requests.get(url, headers={
    "User-Agent": "Mozilla/5.0"
})
selector = Selector(resp.text)
data = selector.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
profile = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.user-detail"]["userInfo"]
print(profile)
La balise __UNIVERSAL_DATA_FOR_REHYDRATION__ contient le bloc JSON que TikTok injecte dans les pages profil et vidéo. Ce bloc contient les métadonnées du profil : nombre d’abonnés, nombre d’abonnements, biographie et identifiant utilisateur. Cette méthode s’inspire d’exemples concrets documentés par ScrapFly.
Étape 3 : extraire les données pertinentes
Tu peux ensuite filtrer le JSON pour ne garder que l’essentiel : identifiant, statistiques d’engagement, description. Voici un exemple avec ScrapFly pour les posts TikTok :
from scrapfly import ScrapeConfig, ScrapflyClient
import json, jmespath

SCRAPFLY = ScrapflyClient(key="TA_CLE")
CONFIG = {"asp": True, "country": "US"}

def parse_post(response):
    sel = response.selector
    data = sel.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
    post = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return jmespath.search(
        """{
        id: id,
        desc: desc,
        author: author.{uniqueId, nickname},
        stats: stats
        }""",
        post
    )

async def scrape_posts(urls):
    to_scrape = [ScrapeConfig(url, **CONFIG) for url in urls]
    results = []
    async for resp in SCRAPFLY.concurrent_scrape(to_scrape):
        results.append(parse_post(resp))
    return results
Ce code montre comment parser proprement les données clés d’un post : identifiant, description, auteur et statistiques d’engagement (likes, commentaires, vues, partages). Le résultat peut ensuite être converti en CSV pour tes analyses.
Étape 4 : gérer l’itération et la pagination
L’API interne de TikTok ne renvoie souvent qu’une petite partie des résultats à la fois. Pour obtenir plus de commentaires, tu dois gérer la pagination avec une boucle while, qui continue à envoyer des requêtes vers l’endpoint tant qu’il reste des données à charger.
cursor = 0
all_data = []
while True:
    params = {"count": 20, "cursor": cursor, "aweme_id": post_id}
    resp = requests.get(api_url, params=params)
    data = resp.json()
    comments = data.get("comments", [])
    all_data.extend(comments)
    if not data.get("total") or cursor >= data["total"]:
        break
    cursor += params["count"]
Code simplifié : remplace api_url par https://www.tiktok.com/api/comment/list/ et post_id par l’ID de la vidéo. En pratique, TikTok exige aussi des paramètres de session récupérés depuis le navigateur, d’où l’intérêt de passer par ScrapFly ou un navigateur headless.
Ici, on exploite le paramètre cursor pour paginer via l’endpoint interne des commentaires. Chaque itération récupère un lot de 20 résultats jusqu’à épuisement complet des données.
Pourquoi faire du scraping sur TikTok ?
Récolter des données publiques sur TikTok sert à prendre de meilleures décisions, que tu bosses dans le marketing, la data ou la recherche. Voici cinq cas d’usage concrets où extraire des données TikTok fait vraiment la différence :
- L’analyse de marché : tu repères les tendances émergentes (trending hashtags, sons populaires, niches de contenus). En suivant les trends qui montent, tu détectes un sujet avant qu’il devienne saturé.
- Le marketing d’influence : tu identifies les créateurs pertinents pour ta marque en comparant leur nombre de followers, leur taux d’engagement réel et les performances de leurs posts, au lieu de te fier aux chiffres affichés.
- L’analyse de sentiment : tu évalues la perception d’une marque en récoltant les commentaires sous les vidéos, pour voir si les réactions sont positives, négatives ou neutres à grande échelle.
- La recherche académique : les données extraites permettent d’étudier des phénomènes sociaux ou culturels qui se manifestent sur la plateforme, avec des échantillons chiffrés et reproductibles.
- La veille concurrentielle : tu surveilles la stratégie de contenu de tes concurrents en suivant la fréquence de leurs publications, les formats qui marchent et les vidéos qui génèrent le plus de likes et de vues.
Dans tous ces cas, le respect des CGU de TikTok et du RGPD reste ta responsabilité, surtout dès que tu manipules des informations liées à des utilisateurs identifiables.
FAQ
Est-ce que le web scraping sur TikTok est légal ?
C’est une question nuancée. En général, le scraping de données publiques sur TikTok n’est pas illégal en soi, mais tu dois respecter deux choses : les conditions d’utilisation de TikTok, qui interdisent la collecte automatisée dans leurs CGU, et les lois sur la protection des données personnelles comme le RGPD en Europe.
Concrètement, extraire des informations publiques (hashtags, tendances, statistiques agrégées) pose moins de problèmes que collecter des données nominatives (emails, profils identifiables). Si tu stockes des données personnelles, tu engages ta responsabilité au regard du RGPD. Pour plus de détails, va lire notre article sur la légalité du web scraping.
Quels sont les meilleurs outils ou logiciels pour scraper TikTok ?
Tout dépend de tes besoins et de tes compétences techniques.
- Pour débuter sans coder : Octoparse est la solution la plus simple, avec son interface visuelle.
- Pour des projets à gros volume : Bright Data excelle grâce à ses proxies intégrés et son infrastructure anti-blocage.
- Pour automatiser dans le cloud : Apify propose un TikTok Scraper prêt à l’emploi avec export en JSON ou CSV.
Si tu préfères coder toi-même, Python avec des bibliothèques comme Selenium ou le SDK ScrapFly te donne le plus de contrôle sur tes extractions. Pour une comparaison détaillée (prix, avantages, limites), consulte notre article sur les meilleurs outils de web scraping.
Quelles données peut-on extraire de TikTok ?
Tu peux extraire une grande variété d’informations publiques sur TikTok :
- Profils d’utilisateurs : nom, biographie, nombre d’abonnés, nombre d’abonnements, user id.
- Métadonnées des vidéos et posts : description, durée, date de publication, musique associée
- Hashtags et trends du moment
- Statistiques d’engagement : likes, partages, commentaires, vues
Toutes ces données sont renvoyées dans un format structuré (JSON), facile à convertir en CSV pour tes analyses.
Comment contourner les protections anti-bot de TikTok ?
TikTok déploie plusieurs mesures pour bloquer les scrapers, notamment l’analyse du comportement de navigation, l’empreinte technique des requêtes (TLS, en-têtes, cookies) et la réputation des adresses IP.
Ces protections restent gérables avec les bonnes pratiques :
- Utiliser des proxies résidentiels tournants (les IP de datacenter sont vite repérées).
- Simuler un vrai navigateur avec Selenium.
- Ajouter des délais aléatoires entre les requêtes pour éviter de surcharger les serveurs.
Plus tu scrapes vite, plus tu risques d’être détecté. Un rythme raisonnable protège autant TikTok que ton propre accès.








 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA