TikTok er en guldgrube af data: profiler, hashtags, videostatistikker, kommentarer. Med web scraping kan du udtrække alt dette automatisk. Der er to muligheder: at bruge en færdiglavet værktøj (uden kode) eller skrive din egen kode skraber i Python.
Her følger en trinvis vejledning med de oplysninger, du kan indhente, og hvad loven siger.

De forskellige metoder til scraping på TikTok
Til TikTok-skraber, findes der to hovedtilgange. Valget afhænger af dine tekniske færdigheder og projektets kompleksitet.
- Brug specialværktøjer (uden kode).
- Skriv din egen scraper i Python.
1. Brug af webscraping-værktøjer
Det er den mest hurtigt og nemt, som er perfekt, hvis du slet ikke har nogen programmeringserfaring. Disse værktøjer tilbyder nøglefærdige løsninger og tager sig af de tekniske udfordringer for dig: omgåelse af bot-beskyttelse, rotation af fuldmagter, sessionstyring.
Her er tre TikTok-scrapere effektive:
- Bright Data
- Apify
- Octoparse
Lyse data
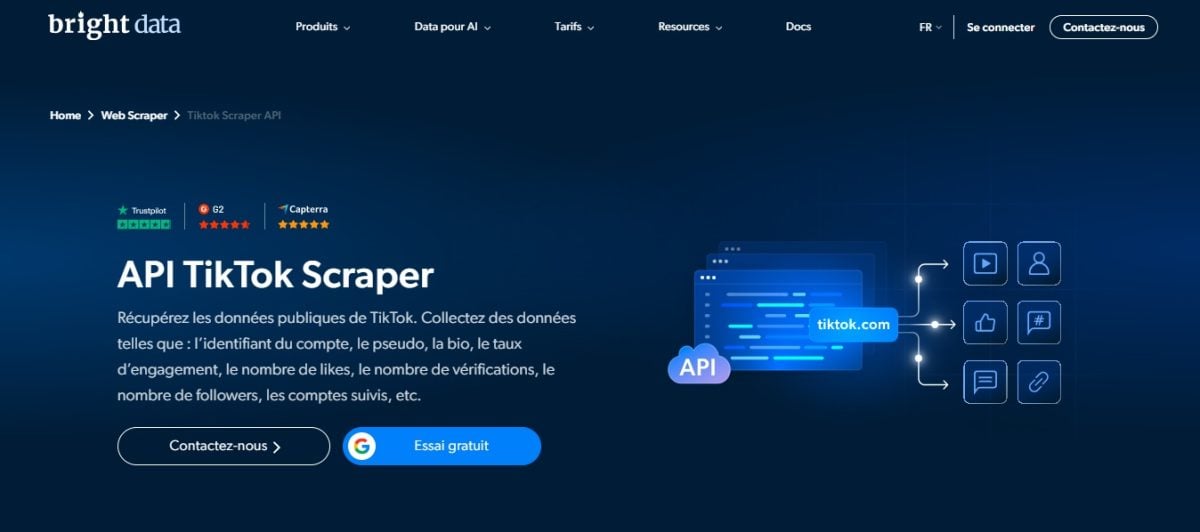
Lyse data er en komplet løsning, der er kendt for sine proxy-tjenester (til privatbrug og mobilbrug) og sine avancerede scraping-værktøjer: dedikerede API’er, integreret scraping-browser. Dens TikTok-skraber indsamling af data om profiler, indlæg (inklusive hashtags) og kommentarer. Resultaterne kan eksporteres til JSON eller i CSV til dine analyser.
Det er det bedste valg, når dit projekt kræver masser af volumen og en pålidelig infrastruktur. Vi fortæller dig mere om det i vores fuld gennemgang af Bright Data.
Apify

Apify er en cloud-platform til udvikling af skrabere i stand til at udføre udtræk i stor skala.
Hans TikTok-skraber indhenter detaljerede oplysninger: brugerprofiler, hashtags, musik knyttet til videoerne og komplette metadata for indlæggene. Kommentarerne udtrækkes ved hjælp af et dedikeret værktøj, TikTok Comments Scraper.
Dette er den den mest fleksible løsning, hvilket er ideelt, når du vil tilpasse dine dataudtræk eller automatisere tilbagevendende opgaver i skyen. Dataene eksporteres til JSON Hvor CSV direkte fra brugergrænsefladen. Se vores Fuld anmeldelse af Apify.
Oktoparse
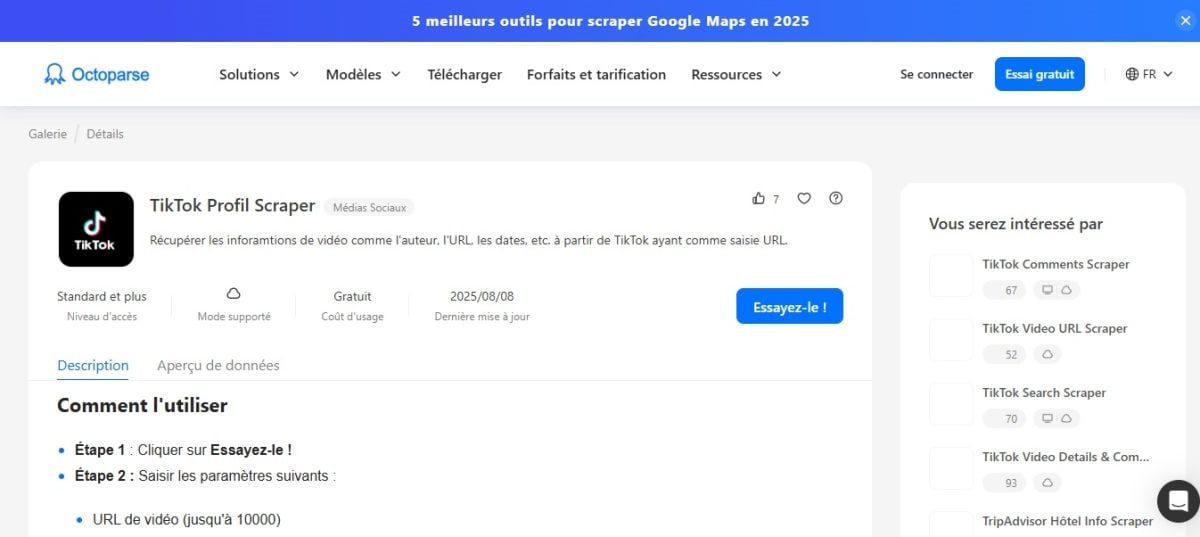
Oktoparse er en Løsning uden kode hvis visuelle brugergrænseflade giver dig mulighed for at oprette en scraper med blot et par klik, uden at skrive en eneste linje kode. Værktøjet tilbyder også en skabelon TikTok Scraper klar til brug, som du derefter kan tilpasse efter dine behov.
Det er den mest overkommelige løsning for en nybegynder der ønsker at udtrække data hurtigt. Læs mere i vores fuld anmeldelse af Octoparse.
2. Skrabning af kode med Python
det webscraping med Python er en mere teknisk og kan tilpasses, som kræver grundlæggende programmeringskendskab. Det er den ideelle løsning, hvis du vil have en total kontrol om de data, der skal udtrækkes, og udgangsformaterne (JSON, CSV) og antallet af forespørgsler. Her følger en trinvis vejledning.
Forudsætninger
Til at begynde med skal du installere nogle Python-biblioteker:
pip install requests parsel jmespath selenium scrapfly-sdk
Denne kommando installerer :
- Requests for HTTP-anmodninger.
- Parsel til at analysere HTML-indholdet (XPath-selektorer).
- JMESPath for at filtrere JSON-dataene.
- Selenium for at administrere JavaScript-sider hvis det er nødvendigt.
- scrapfly-sdk, ScrapFly-SDK’en (en betaltjeneste med 1 000 gratis kreditter til afprøvning), som bruges længere nede til at håndtere anti-bot og proxyservere.
Den metode, der anvendes her, bygger på udtræk af data fra en profil eller en video via’analyse af JSON skjult på TikTok-siden.
TikTok indsætter disse data direkte i sidens HTML-kode i en -tag, hvilket gør det unødvendigt at kalde en officiel API.
Trin 1: Analyse af netværksforespørgslen
- Åbn dem udviklingsværktøjer (F12) i din browser.
- I den Network, bemærk de Indlæste anmodninger når du besøger en profil eller en video på tiktok.com.
- Find datakilden. For en profil eller en video er det -taget, som kan ses i sidens kildekode (fanen »Elements«). For kommentarer er det XHR-anmodninger til en URL af typen /api/comment/list/, som kan ses under fanen "Network". Deres fulde URL vises under fanen "Headers".
- For en profil eller en video skal du blot bruge sidens URL; for kommentarer skal du bruge endpointets URL.
Trin 2: Send anmodningen og modtag svaret
Når kilden er identificeret, skal du bruge Python for at hente siden og udtrække den JSON, den indeholder.
import requests
from parsel import Selector
import json

url = "https://www.tiktok.com/@pseudo"  # erstattes med den ønskede URL
resp = requests.get(url, headers={
    "User-Agent": "Mozilla/5.0"
})
selector = Selector(resp.text)
data = selector.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
profile = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.user-detail"]["userInfo"]
print(profile)
Tagget __UNIVERSAL_DATA_FOR_REHYDRATION__ indeholder den JSON-blok, som TikTok indsætter på profil- og videosiderne. Denne blok indeholder profilens metadata: antal følgere, antal abonnementer, biografi og bruger-ID. Denne metode er inspireret af konkrete eksempler, der er dokumenteret af ScrapFly.
Trin 3: Udtræk de relevante data
Derefter kan du filtrer JSON for kun at beholde det væsentligste: brugernavn, engagementstatistikker, beskrivelse. Her er et eksempel med ScrapFly til TikTok-indlæg :
from scrapfly import ScrapeConfig, ScrapflyClient
import json, jmespath

SCRAPFLY = ScrapflyClient(key="TA_CLE")
CONFIG = {"asp": True, "country": "US"}

def parse_post(response):
    sel = response.selector
    data = sel.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
    post = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return jmespath.search(
 """{
 id: id,
 desc: desc,
 author: author.{uniqueId, nickname},
        stats: stats
 }""",
 post
    )

async def scrape_posts(urls):
    to_scrape = [ScrapeConfig(url, **CONFIG) for url in urls]
    results = []
    async for resp in SCRAPFLY.concurrent_scrape(to_scrape):
 results.append(parse_post(resp))
    return results
Denne kode viser, hvordan at parse korrekt de vigtigste oplysninger i et indlæg: brugernavn, beskrivelse, forfatter og engagementstatistikker (kan lide, kommentarer, visninger, delinger). Resultatet kan derefter omregnes til CSV til dine analyser.
Trin 4: Håndtering af iteration og paginering
TikToks interne API returnerer ofte kun en lille del af resultaterne ad gangen. For at hente flere kommentarer skal du håndtere paginering ved hjælp af en løkke while, som fortsætter med at sende anmodninger til endpointet, så længe der stadig er data, der skal indlæses.
cursor = 0
all_data = []
while True:
    params = {"count": 20, "cursor": cursor, "aweme_id": post_id}
    resp = requests.get(api_url, params=params)
    data = resp.json()
    comments = data.get("comments", [])
    all_data.extend(comments)
    if not data.get("total") or cursor >= data["total"]:
 break
    cursor += params["count"]
Forenklet kode : Erstat »api_url« med »https://www.tiktok.com/api/comment/list/« og »post_id« med videoens ID. I praksis kræver TikTok også sessionsparametre, der hentes fra browseren, og derfor er det en fordel at bruge ScrapFly eller en headless-browser.
Her udnytter man parameteren cursor til sider inddeles via det interne endpoint kommentarer. Hver iteration henter et sæt på 20 resultater, indtil alle data er gennemgået.
Hvorfor skrotte på TikTok?
Indsamling af offentlige data på TikTok hjælper med at træffe bedre beslutninger, uanset om du arbejder inden for marketing, data eller forskning. Her er fem konkrete anvendelsestilfælde, hvor udtræk af data fra TikTok virkelig gør en forskel:
- Markedsanalysen: du finder dem nye tendenser (trending hashtags, populære lydklip, indholdsnicher). Ved at følge de nye trends kan du spotte et emne, før det bliver overfyldt.
- Influencer-marketing: Du finder de relevante influencere til dit brand ved at sammenligne deres antal følgere, deres forpligtelsesgrad den reelle rækkevidde og resultaterne af deres indlæg, i stedet for at stole på de tal, der vises.
- Sentimentanalyse: Du vurderer opfattelsen af et mærke ved at indsamle kommentarer under videoerne, for at se, om reaktionerne generelt er positive, negative eller neutrale.
- Akademisk forskning: De udtrukne data gør det muligt at undersøge sociale eller kulturelle fænomener der kommer til udtryk på platformen, med talbaserede og reproducerbare eksempler.
- Konkurrenceovervågning: Du holder øje med dine konkurrenters indholdsstrategi ved at følge, hvor ofte de offentliggør indhold, hvilke formater der fungerer, og videoer der genererer flest likes og visninger.
I alle disse tilfælde skal TikToks brugsbetingelser og RGPD er dit ansvar, især når du håndterer oplysninger om identificerbare brugere.
Ofte stillede spørgsmål
Er webscraping på TikTok lovligt?
Det er et nuanceret spørgsmål. Generelt er det ikke i sig selv ulovligt at scrape offentlige data på TikTok, men du skal overholde to ting: de betingelser for brug af TikTok, som i deres brugsbetingelser forbyder automatiseret dataindsamling, samt lovgivningen om beskyttelse af personoplysninger, såsom RGPD i Europa.
Konkret er det mindre problematisk at udtrække offentlige oplysninger (hashtags, trends, aggregerede statistikker) end at indsamle personoplysninger (e-mailadresser, identificerbare profiler). Hvis du opbevarer personoplysninger, påtager du dig et ansvar i henhold til GDPR. For yderligere oplysninger kan du læse vores artikel om Lovligheden af webscraping.
Hvad er de bedste værktøjer og den bedste software til at scrape TikTok?
Det afhænger helt af dine behov og dine tekniske færdigheder.
- Sådan kommer du i gang uden at programmere: Octoparse er den enkleste løsning med sin visuelle brugergrænseflade.
- Til store projekter: Bright Data udmærker sig takket være sine indbyggede proxyservere og sin infrastruktur til forebyggelse af blokeringer.
- Sådan automatiserer du i skyen: Apify foreslår en TikTok-skraber klar til brug med eksport til JSON Hvor CSV.
Hvis du hellere vil programmere selv, Python med biblioteker som Selenium eller SDK'en ScrapFly giver dig størst mulig kontrol over dine udtræk. For en detaljeret sammenligning (priser, fordele, begrænsninger) kan du læse vores artikel om De bedste værktøjer til webscraping.
Hvilke data kan udtrækkes fra TikTok?
Du kan hente en lang række offentlige oplysninger på TikTok:
- Brugerprofiler: navn, biografi, antal følgere, antal personer, man følger, bruger-id.
- Metadata for videoer og indlæg: beskrivelse, varighed, offentliggørelsesdato, tilknyttet musik
- Hashtags og aktuelle trends
- Statistikker over brugeraktivitet: kan lide, delinger, kommentarer, visninger
Alle disse data returneres i et struktureret format (JSON), der let kan konverteres til CSV til dine analyser.
Hvordan kan jeg omgå TikToks anti-bot-beskyttelse?
TikTok iværksætter en række foranstaltninger for at blokere scrapers, herunder analyse af browsingadfærd, teknisk fingeraftryk af forespørgsler (TLS, headere, cookies) og IP-adressers omdømme.
Disse beskyttelsesforanstaltninger kan håndteres ved at følge de bedste praksis:
- Brug skiftende private proxyservere (IP-adresser fra datacentre bliver hurtigt opdaget).
- Simulere en rigtig browser med Selenium.
- Tilføj tilfældige forsinkelser mellem anmodninger for at undgå at overbelaste serverne.
Jo hurtigere du scraper, desto større er risikoen for, at du bliver opdaget. Et rimeligt tempo beskytter både TikTok og din egen adgang.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA