チクタク データが豊富に揃っています:プロフィール、, ハッシュタグ, 、動画の統計データ、コメント。ウェブスクレイピングを使えば、これらすべてを自動的に抽出できます。2つの方法があります: すぐに使えるツール (コードなし)または自分でコードを書く スクレイパー の パイソン.
ここでは、入手可能なデータと法律の規定に基づき、手順ごとにその方法をご説明します。.

TikTokでのスクレイピングのさまざまな方法
為に TikTokスクレーパー, 、主に2つのアプローチがあります。どちらを選ぶかは、あなたの技術的なスキルとプロジェクトの複雑さによって異なります。.
- 専用のツールを使用する (コードなし)。.
- Pythonで独自のスクレイパーをコーディングする.
1.ウェブスクレイピングツールの使用
これは最も 迅速かつ簡単, 、プログラミングの知識がまったくない人にも最適です。これらのツールは、 ターンキー・ソリューション そして、技術的な課題をあなたに代わって処理します:ボット対策の回避、ローテーションの 代理人, 、セッション管理。.
以下はその3つである。 TikTokスクレイパー 効果的なもの:
- Bright Data
- Apify
- Octoparse
ブライトデータ
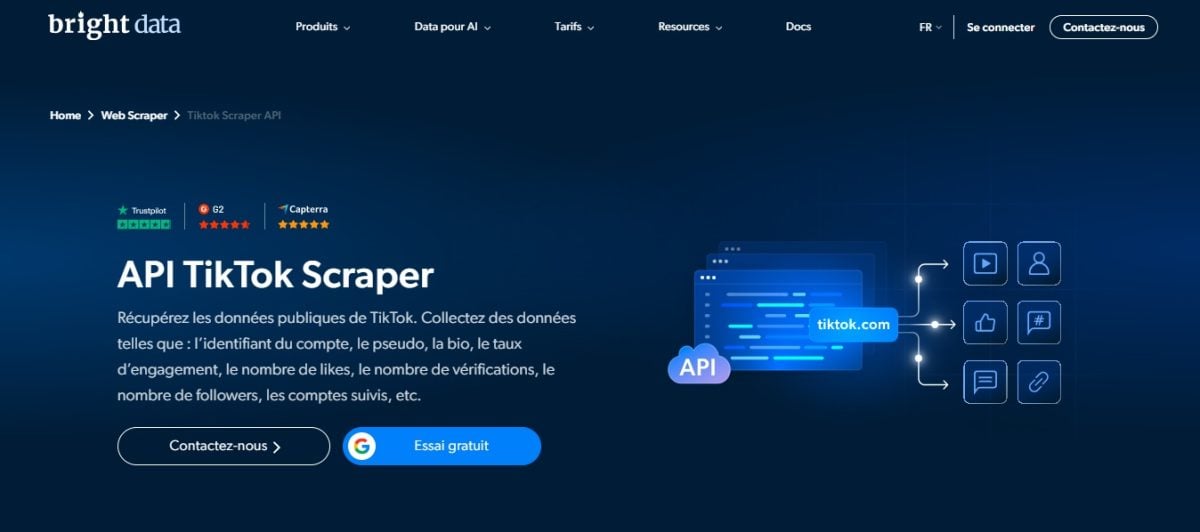
ブライトデータ は、プロキシサービス(住宅用およびモバイル用)と、専用APIや組み込みのスクレイピングブラウザといった高度なスクレイピングツールで定評のある包括的なソリューションです。その TikTokスクレーパー プロフィール、投稿(ハッシュタグを含む)、コメントに関するデータを収集します。結果は以下の形式でエクスポート可能です。 JSON またはで シーエスブイ 分析について。.
プロジェクトに以下が必要とされる場合、これが最良の選択です ボリュームたっぷり そして、信頼性の高いインフラ。その詳細については、当社の ブライト・データのレビュー.
アピファイ

アピファイ は、 スクレーパーの開発 大規模なデータ抽出を実行できる。.
彼の TikTokスクレーパー 詳細な情報を取得します:ユーザープロフィール、ハッシュタグ、動画に関連付けられた音楽、投稿の完全なメタデータなどです。コメントは、専用のツール「TikTok Comments Scraper」を使用して抽出されます。.
これは 最も柔軟な解決策, 、クラウド上で抽出処理をカスタマイズしたり、繰り返し行うタスクを自動化したりしたい場合に最適です。データは JSON どこ シーエスブイ インターフェースから直接。詳細については、当社の Apifyのレビュー.
オクトパース
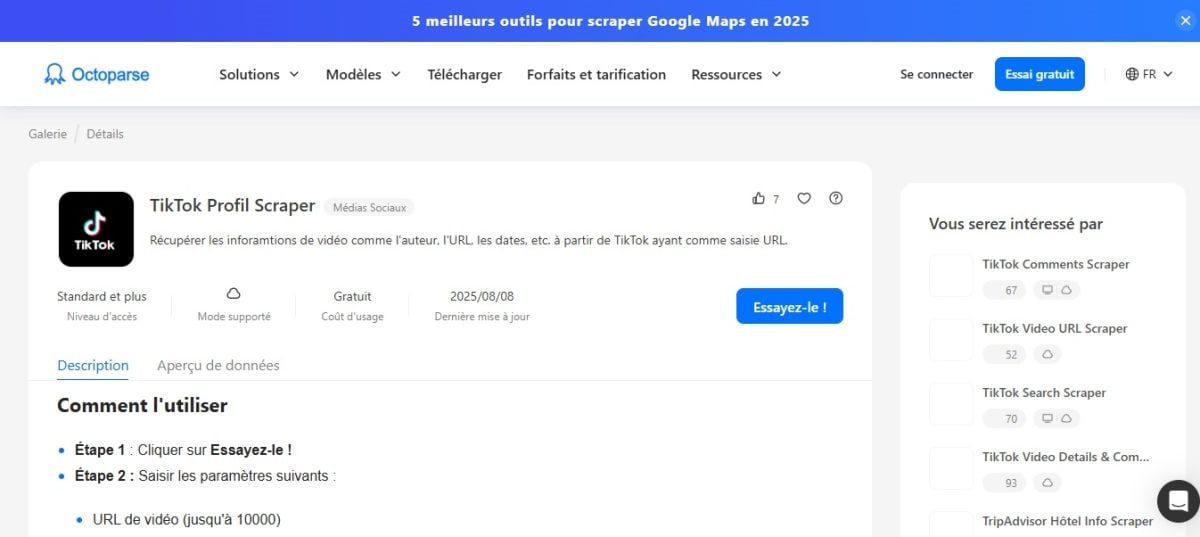
オクトパース です ノーコード・ソリューション その直感的なインターフェースを使えば、コードを1行も書くことなく、わずか数回のクリックでスクレイパーを作成できます。また、このツールには テンプレートTikTokスクレーパー すぐに使える状態で、その後、必要に応じてカスタマイズできます。.
これは、~にとって最も手頃な選択肢です。 初心者 データを素早く抽出したい方。詳細については、当社の オクトパースのレビュー.
2.Pythonによるコードのスクレイピング
the Pythonを使ったスクレイピング は、より 技術的でカスタマイズ可能, 、プログラミングの基礎知識が必要です。もしあなたが トータル・コントロール 抽出するデータ、出力形式(JSON, シーエスブイ)およびリクエストの頻度。手順を段階ごとに説明します。.
前提条件
まずは、いくつかのPythonライブラリをインストールしましょう:
pip install requests parsel jmespath selenium scrapfly-sdk
このコマンドは.NET Frameworkをインストールします:
- Requests のために HTTPリクエスト.
- Parsel HTMLコンテンツを解析するため(XPathセレクタ)。.
- JMESPath JSONをフィルタリングするために。.
- Selenium を管理するために JavaScriptページ 必要であれば。.
- scrapfly-sdk, 、ScrapFlyのSDK(有料サービス。試用用に1,000クレジットが無料で付与されます)は、後述の通り、ボット対策やプロキシの管理に使用されます。.
ここで採用されている手法は、プロフィールや動画からデータを抽出することに基づいており、その方法は……’JSONの解析 TikTokのページに隠されています。.
TikTokは、これらのデータをページのHTML内のタグに直接埋め込むため、公式APIを呼び出す必要がありません。.
ステップ1:ネットワークリクエストの分析
- 開く 開発ツール (F12) お使いのブラウザで。.
- の中で Network, は以下の点を観察する リクエスト tiktok.comでプロフィールや動画を閲覧するとき。.
- データの出所を特定します。プロフィールや動画の場合、ページのソースコード(「要素」タブ)に表示される タグがそれにあたります。 コメントの場合は、/api/comment/list/ のような URL への XHR リクエストであり、「ネットワーク」タブで確認できます。その完全な URL は「ヘッダー」タブに表示されます。.
- プロフィールや動画の場合は、そのページのURLをそのまま使用します。コメントの場合は、エンドポイントのURLを使用します。.
ステップ2:リクエストを送信し、応答を受け取る
情報源が特定できたら、次の手順を実行してください パイソン そのページにリクエストを送信し、そこに含まれるJSONを抽出するため。.
import requests
from parsel import Selector
import json

url = "https://www.tiktok.com/@pseudo"  # を対象のURLに置き換えてください
resp = requests.get(url, headers={
    "User-Agent": "Mozilla/5.0"
})
selector = Selector(resp.text)
data = selector.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
profile = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.user-detail"]["userInfo"]
print(profile)
タグ __UNIVERSAL_DATA_FOR_REHYDRATION__ には、TikTokがプロフィールページや動画ページに挿入するJSONブロックが含まれています。このブロックには、フォロワー数、フォロー数、プロフィール文、ユーザーIDといったプロフィールのメタデータが含まれています。この手法は、以下の資料に記載された具体的な事例を参考にしています。 スクラップフライ.
ステップ3:関連データを抽出する
その後、あなたは フィルターJSON 要点を絞り込むと、ユーザーID、エンゲージメント統計、説明となります。以下に、ScrapFly を使った例を挙げます。 TikTokの投稿 :
from scrapfly import ScrapeConfig, ScrapflyClient
import json, jmespath

SCRAPFLY = ScrapflyClient(key="TA_CLE")
CONFIG = {"asp": True, "country": "US"}

def parse_post(response):
    sel = response.selector
    data = sel.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
    post = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return jmespath.search(
 """{
 id: id,
 desc: desc,
 author: author.{uniqueId, nickname},
        stats: stats
 }""",
 post
    )

async def scrape_posts(urls):
    to_scrape = [ScrapeConfig(url, **CONFIG) for url in urls]
    results = []
    async for resp in SCRAPFLY.concurrent_scrape(to_scrape):
 results.append(parse_post(resp))
    return results
このコードは 適切に解析する 投稿の主要なデータ:ID、説明、投稿者、エンゲージメント統計(好き, (コメント、閲覧数、シェア)。その結果は、その後、 シーエスブイ 分析について。.
ステップ4:反復処理とページネーションの管理
TikTokの内部APIは、一度に検索結果のごく一部しか返さないことがよくあります。より多くのコメントを取得するには、ループを使ってページネーションを処理する必要があります。 while, 読み込むデータが残っている限り、エンドポイントへのリクエストを送り続ける。.
cursor = 0
all_data = []
while True:
    params = {"count": 20, "cursor": cursor, "aweme_id": post_id}
    resp = requests.get(api_url, params=params)
    data = resp.json()
    comments = data.get("comments", [])
    all_data.extend(comments)
    if not data.get("total") or cursor >= data["total"]:
 break
    cursor += params["count"]
簡略化されたコード : api_url を https://www.tiktok.com/api/comment/list/ に、post_id を動画のIDに置き換えてください。実際には、TikTokではブラウザから取得したセッションパラメータも必要となるため、ScrapFlyやヘッドレスブラウザを利用するのが有効です。.
ここでは、このパラメータを活用しています cursor 為に 内部エンドポイント経由でページネーションを行う コメント。各反復処理では、データが完全に使い果たされるまで、20件の結果をまとめて取得します。.
なぜTikTokでスクラップをするのか?
TikTokから公開データを収集することは、マーケティング、データ分析、調査のいずれの分野に携わっている場合でも、より良い意思決定を行うために役立ちます。ここでは、TikTokからデータを抽出することが大きな違いをもたらす5つの具体的な活用例をご紹介します:
- 市場分析: それらを見つけると 新たなトレンド (トレンドのハッシュタグ、人気のサウンド、ニッチなコンテンツ)。台頭しつつあるトレンドを追うことで、そのトピックが飽和状態になる前に見極めることができる。.
- インフルエンサー・マーケティング: フォロワー数や、 コミットメント・レート 表示されている数字だけを鵜呑みにするのではなく、実際の状況や投稿のパフォーマンスを把握するようにしましょう。.
- センチメント分析: ブランドに対する認識を評価するために、以下の情報を収集する コメント 動画の下にあるコメント欄を見て、反応が全体的に肯定的か、否定的か、あるいは中立的かを確認するため。.
- 学術研究: 抽出されたデータを用いて、以下のことを研究することができる。 社会的・文化的現象 プラットフォーム上で確認される現象について、数値データによる実証可能な事例を提示する。.
- 競合分析: 競合他社のコンテンツ戦略を、投稿頻度や効果的なフォーマットなどを追跡して監視し、 ビデオ 「いいね」や「再生回数」が最も多いもの。.
いずれの場合も、TikTokの利用規約および RGPD その責任はあなたにあります。特に、特定可能なユーザーに関する情報を扱う場合はなおさらです。.
よくある質問
TikTokでのウェブスクレイピングは合法か?
これは一概には言えない問題です。一般的に、TikTok上の公開データをスクレイピングすること自体は違法ではありませんが、次の2つの点を遵守する必要があります: TikTokの使用条件, 、利用規約(利用規約)において自動収集を禁止しているものや、次のような個人情報保護法など RGPD ヨーロッパで。.
具体的には、公開情報(ハッシュタグ、トレンド、集計統計)を抽出することは、個人を特定できるデータ(メールアドレス、個人を特定できるプロフィール)を収集するよりも問題が少ない。個人データを保存する場合、GDPRに基づく責任を負うことになる。詳細については、当社の記事「 ウェブ・スクレイピングの合法性.
TikTokのスクレイピングに最適なツールやソフトウェアは?
それは、あなたのニーズや技術的なスキル次第です。.
- コーディングなしで始めるには: Octoparse 直感的なインターフェースを備えており、最もシンプルな解決策です。.
- 大規模なプロジェクトの場合: Bright Data 組み込みのプロキシとブロッキング防止インフラにより、優れた性能を発揮します。.
- クラウドでの自動化を行うには: Apify 提案する TikTokスクレーパー すぐに使える状態で、以下の形式でエクスポート可能 JSON どこ シーエスブイ.
もし自分でコーディングしたいなら、, Python 次のようなライブラリを使って Selenium またはSDK ScrapFly 抽出作業を最も細かく制御できます。詳細な比較(価格、メリット、制限)については、当サイトの 最高のウェブスクレイピングツール.
TikTokからどのようなデータを抽出できますか?
TikTokからは、さまざまな公開情報を抽出することができます:
- ユーザープロフィール:名前、プロフィール、フォロワー数、フォロー数、ユーザーID。.
- 動画および投稿のメタデータ:説明、再生時間、公開日、関連する音楽
- 今注目のハッシュタグとトレンド
- エンゲージメント統計: 好き, 、シェア、コメント、再生回数
これらのデータはすべて、構造化された形式で返されます(JSON), 簡単に変換できる シーエスブイ 分析について。.
TikTokのアンチボット・プロテクションを回避するには?
TikTokは、スクレイパーをブロックするために、閲覧行動の分析、リクエストの技術的フィンガープリント(TLS、ヘッダー、クッキー)、IPアドレスのレピュテーションなど、さまざまな対策を講じています。.
これらの保護対策は、適切な手法を用いれば適切に管理することができます:
- ローテーション式の住宅用プロキシを使用する(データセンターのIPアドレスはすぐに特定されてしまう)。.
- 実際のブラウザをエミュレートするには Selenium.
- 追加 ランダム遅延 サーバーへの負荷を避けるため。.
スクレイピングの速度が速ければ速いほど、検知されるリスクが高まります。適度なペースを保つことで、TikTokと自身のアクセス権の両方を守ることができます。.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA