TikTok é uma fonte inestimável de dados: perfis, hashtags, estatísticas de vídeos, comentários. O web scraping permite-te extrair tudo isso automaticamente. Tens duas opções à tua disposição: utilizar um ferramenta pronta a usar (sem código) ou programar o teu próprio raspador dentro Python.
Eis como proceder, passo a passo, com os dados que podes obter e o que diz a lei.

Os diferentes métodos de scraping no TikTok
Por Raspador do TikTok, existem duas abordagens principais. A escolha depende das tuas competências técnicas e da complexidade do teu projeto.
- Utilizar ferramentas específicas (sem código).
- Programar o teu próprio scraper em Python.
1. Utilizar ferramentas de recolha de dados da Web
É a abordagem mais rápido e fácil, ideal se não tiveres quaisquer conhecimentos de programação. Estas ferramentas oferecem soluções chave na mão e tratam, por ti, dos desafios técnicos: contornar as proteções anti-bot, alternar entre proxies, gestão de sessões.
Aqui estão três scrapers do TikTok eficazes:
- Bright Data
- Apify
- Octoparse
Dados brilhantes
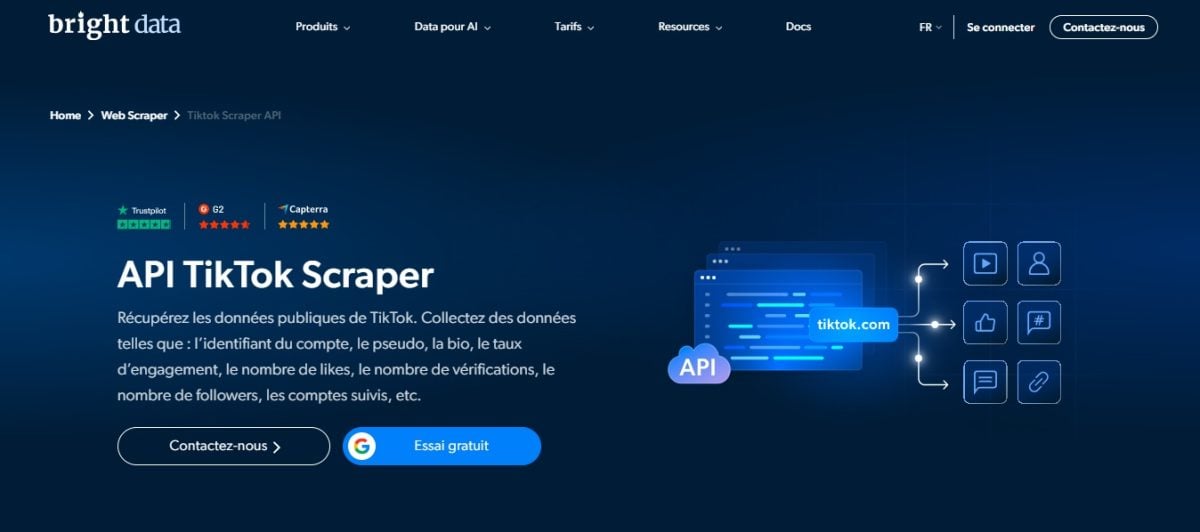
Dados brilhantes é uma solução completa, reconhecida pelos seus serviços de proxies (residenciais e móveis) e pelas suas ferramentas avançadas de scraping: APIs dedicadas, navegador de scraping integrado. O seu Raspador TikTok recolha de dados sobre perfis, publicações (incluindo hashtags) e comentários. Os resultados podem ser exportados para JSON ou em CSV pelas tuas análises.
É a melhor escolha quando o teu projeto exige muito volume e uma infraestrutura fiável. Falamos-te disso em pormenor no nosso análise completa da Bright Data.
Apify

Apify é uma plataforma na nuvem de desenvolvimento de raspadores capaz de realizar extrações em grande escala.
Dele Raspador TikTok recupera informações detalhadas: perfis de utilizadores, hashtags, música associada aos vídeos e metadados completos das publicações. Os comentários são extraídos por uma ferramenta específica, o TikTok Comments Scraper.
Este é o solução mais flexível, ideal quando queres personalizar as tuas extrações ou automatizar tarefas recorrentes na nuvem. Os dados são exportados para JSON Onde CSV diretamente a partir da interface. Para mais informações, consulta o nosso análise completa da Apify.
Octoparse
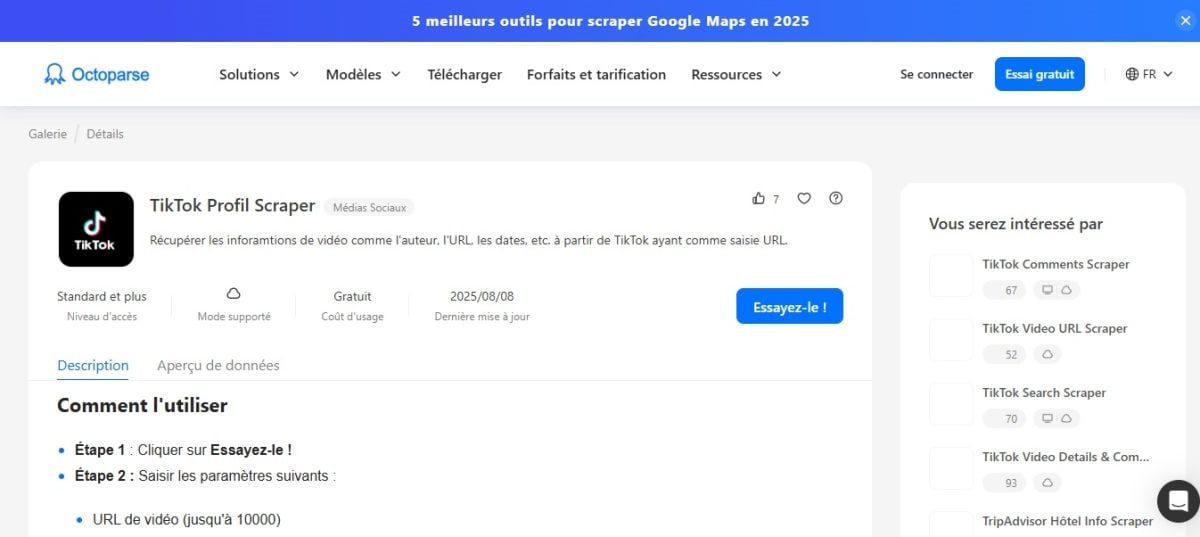
Octoparse é um solução sem código cuja interface visual te permite criar um scraper com apenas alguns cliques, sem precisares de escrever uma única linha de código. A ferramenta também oferece um modelo TikTok Scraper pronto a usar, que podes depois personalizar de acordo com as tuas necessidades.
É a opção mais acessível para um principiante que queira extrair dados rapidamente. Para saberes mais, lê o nosso análise completa do Octoparse.
2. Raspagem de código com Python
a scraping com Python é uma abordagem mais técnico e personalizável, que requer conhecimentos básicos de programação. É a solução ideal se quiseres um controlo total sobre os dados a extrair, os formatos de saída (JSON, CSV) e a frequência dos pedidos. Eis como proceder, passo a passo.
Pré-requisitos
Para começar, instala algumas bibliotecas Python:
pip install requests parsel jmespath selenium scrapfly-sdk
Este comando instala o :
- Requests para o Pedidos HTTP.
- Parsel para analisar o conteúdo HTML (seletores XPath).
- JMESPath para filtrar o JSON.
- Selenium para gerir os páginas JavaScript se necessário.
- scrapfly-sdk, o SDK do ScrapFly (serviço pago, com 1 000 créditos gratuitos para testar), utilizado mais abaixo para gerir o sistema anti-bot e os proxies.
O método aqui utilizado baseia-se na extração de dados de um perfil ou de um vídeo através do’análise do JSON escondido na página do TikTok.
O TikTok insere esses dados diretamente no código HTML da página, numa etiqueta , o que evita a necessidade de recorrer a uma API oficial.
Passo 1: analisar o pedido de rede
- Abre os ferramentas de desenvolvimento (F12) do teu navegador.
- No Network, observa os pedidos carregados quando visitas um perfil ou um vídeo no tiktok.com.
- Identifica a fonte dos dados. No caso de um perfil ou de um vídeo, trata-se da tag , visível no código-fonte da página (separador «Elements»). No caso dos comentários, trata-se de pedidos XHR para um URL do tipo /api/comment/list/, visíveis no separador «Network». O URL completo aparece no separador «Headers».
- Para um perfil ou um vídeo, basta utilizares o URL da página; para os comentários, o URL do endpoint.
Passo 2: enviar o pedido e obter a resposta
Assim que a fonte for identificada, utiliza Python para consultar a página e extrair o JSON que ela contém.
import requests
from parsel import Selector
import json

url = "https://www.tiktok.com/@pseudo"  # substituir pela URL pretendida
resp = requests.get(url, headers={
    "User-Agent": "Mozilla/5.0"
})
selector = Selector(resp.text)
data = selector.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
profile = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.user-detail"]["userInfo"]
print(profile)
A baliza __UNIVERSAL_DATA_FOR_REHYDRATION__ contém o bloco JSON que o TikTok insere nas páginas de perfil e de vídeo. Este bloco contém os metadados do perfil: número de seguidores, número de seguidos, biografia e identificador do utilizador. Este método inspira-se em exemplos concretos documentados por ScrapFly.
Passo 3: extrair os dados relevantes
Depois, podes filtrar JSON para ficar apenas com o essencial: nome de utilizador, estatísticas de interação, descrição. Aqui está um exemplo com o ScrapFly para os publicações no TikTok :
from scrapfly import ScrapeConfig, ScrapflyClient
import json, jmespath

SCRAPFLY = ScrapflyClient(key="TA_CLE")
CONFIG = {"asp": True, "country": "US"}

def parse_post(response):
    sel = response.selector
    data = sel.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
    post = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return jmespath.search(
 """{
 id: id,
 desc: desc,
 author: author.{uniqueId, nickname},
        stats: stats
 }""",
 post
    )

async def scrape_posts(urls):
    to_scrape = [ScrapeConfig(url, **CONFIG) for url in urls]
    results = []
    async for resp in SCRAPFLY.concurrent_scrape(to_scrape):
 results.append(parse_post(resp))
    return results
Este código mostra como analisar corretamente os dados essenciais de uma publicação: identificador, descrição, autor e estatísticas de interação (gostos, comentários, visualizações, partilhas). O resultado pode, em seguida, ser convertido em CSV pelas tuas análises.
Passo 4: gerir a iteração e a paginação
A API interna do TikTok muitas vezes devolve apenas uma pequena parte dos resultados de cada vez. Para obter mais comentários, tens de gerir a paginação com um ciclo while, que continua a enviar pedidos para o endpoint enquanto houver dados para carregar.
cursor = 0
all_data = []
while True:
    params = {"count": 20, "cursor": cursor, "aweme_id": post_id}
    resp = requests.get(api_url, params=params)
    data = resp.json()
    comments = data.get("comments", [])
    all_data.extend(comments)
    if not data.get("total") or cursor >= data["total"]:
 break
    cursor += params["count"]
Código simplificado : substitua api_url por https://www.tiktok.com/api/comment/list/ e post_id pelo ID do vídeo. Na prática, o TikTok também exige parâmetros de sessão obtidos a partir do navegador, daí a vantagem de utilizar o ScrapFly ou um navegador headless.
Aqui, utilizamos o parâmetro cursor por paginar através do endpoint interno comentários. Cada iteração recupera um lote de 20 resultados até esgotar completamente os dados.
Porquê fazer sucata no TikTok?
A recolha de dados públicos no TikTok serve para tomar melhores decisões, quer estejas no marketing, na análise de dados ou na investigação. Aqui estão cinco casos práticos em que a extração de dados do TikTok faz realmente a diferença:
- A análise de mercado: identificas os tendências emergentes (hashtags em destaque, sons populares, nichos de conteúdo). Ao acompanhar as tendências em ascensão, consegues identificar um tema antes que este fique saturado.
- O marketing de influência: identificas os criadores relevantes para a tua marca, comparando o número de seguidores que têm, o taxa de compromisso o desempenho real das suas publicações, em vez de te baseares nos números apresentados.
- A análise de sentimentos: avalias a perceção de uma marca através da recolha de comentários por baixo dos vídeos, para ver se as reações são positivas, negativas ou neutras em geral.
- A investigação académica: os dados extraídos permitem estudar fenómenos sociais ou culturais que se manifestam na plataforma, com exemplos quantificados e reproduzíveis.
- A análise da concorrência: acompanhas a estratégia de conteúdo dos teus concorrentes, observando a frequência das suas publicações, os formatos que funcionam e os vídeos que geram mais «gostos» e visualizações.
Em todos estes casos, o cumprimento dos Termos e Condições de Utilização do TikTok e do RGPD essa responsabilidade é tua, sobretudo quando lidas com informações relacionadas com utilizadores identificáveis.
Perguntas frequentes
A recolha de dados da Web no TikTok é legal?
Esta é uma questão complexa. Em geral, a recolha de dados públicos no TikTok não é, por si só, ilegal, mas tens de respeitar duas coisas: as condições de utilização do TikTok, que proíbem a recolha automatizada nos seus Termos e Condições de Utilização, e as leis sobre a proteção de dados pessoais, como a RGPD na Europa.
Na prática, extrair informações públicas (hashtags, tendências, estatísticas agregadas) apresenta menos problemas do que recolher dados pessoais (e-mails, perfis identificáveis). Se armazenares dados pessoais, estás sujeito às responsabilidades previstas no RGPD. Para mais detalhes, consulta o nosso artigo sobre o legalidade da recolha de dados na Web.
Quais são as melhores ferramentas e o melhor software para fazer scraping do TikTok?
Tudo depende das tuas necessidades e das tuas competências técnicas.
- Para começar sem programar: Octoparse é a solução mais simples, com a sua interface visual.
- Para projetos de grande volume: Bright Data destaca-se graças aos seus proxies integrados e à sua infraestrutura anti-bloqueio.
- Para automatizar na nuvem: Apify oferece um Raspador TikTok pronto a usar com exportação para JSON Onde CSV.
Se preferires programar por ti próprio, Python com bibliotecas como Selenium ou o SDK ScrapFly dá-te maior controlo sobre as tuas extrações. Para uma comparação detalhada (preços, vantagens, limitações), consulta o nosso artigo sobre as melhores ferramentas de raspagem da web.
Que dados podem ser extraídos do TikTok?
Podes extrair uma grande variedade de informações públicas no TikTok:
- Perfis de utilizadores: nome, biografia, número de seguidores, número de pessoas seguidas, ID de utilizador.
- Metadados dos vídeos e publicações: descrição, duração, data de publicação, música associada
- Hashtags e tendências do momento
- Estatísticas de envolvimento: gostos, partilhas, comentários, visualizações
Todos estes dados são enviados num formato estruturado (JSON), fácil de converter em CSV pelas tuas análises.
Como posso contornar a proteção anti-bot do TikTok?
O TikTok está a implementar várias medidas para bloquear os scrapers, nomeadamente a análise do comportamento de navegação, a impressão digital técnica das solicitações (TLS, cabeçalhos, cookies) e a reputação dos endereços IP.
Estas medidas de proteção continuam a ser fáceis de gerir se forem seguidas as boas práticas:
- Utilizar proxies residenciais rotativos (os IPs dos centros de dados são rapidamente identificados).
- Simular um navegador real com Selenium.
- Adicionar atrasos aleatórios entre pedidos para evitar sobrecarregar os servidores.
Quanto mais depressa fizeres o scrape, maior é o risco de seres detetado. Um ritmo razoável protege tanto o TikTok como o teu próprio acesso.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA