抖音 是一个数据宝库:个人资料、, 主题标签, ,视频统计数据、评论。通过网络爬虫,你可以自动提取所有这些信息。你可以选择两种方法:使用一个 开箱即用工具 (无需编写代码)或编写你自己的代码 刮刀 在 Python.
下面将按步骤详细说明操作方法,包括你可以获取的数据以及相关法律规定。.

在 TikTok 上刮分的不同方法
为了 TikTok 刮刀, ,主要有两种方法。具体选择取决于你的技术能力以及项目的复杂程度。.
- 使用专用工具 (无代码)。.
- 用Python编写自己的网页抓取程序.
1.使用网络搜索工具
这是最……的方法 简单快捷, ,如果你完全没有编程经验,这再合适不过了。这些工具提供了 全套解决方案 并代你处理技术难题:绕过反机器人保护机制、轮换 代理, 会话管理。.
以下是三个 TikTok 抓取工具 有效的:
- Bright Data
- Apify
- Octoparse
亮数据
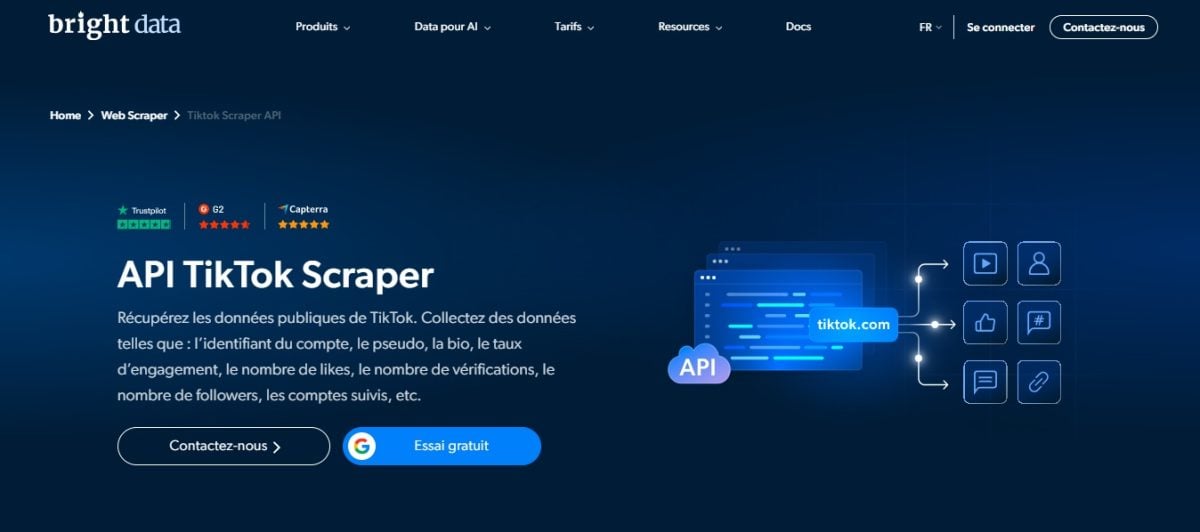
亮数据 是一款功能全面的解决方案,以其代理服务(家庭和移动代理)以及先进的爬虫工具而闻名:专用API、内置爬虫浏览器。其 TikTok 刮刀 收集有关个人资料、帖子(包括话题标签)和评论的数据。结果可导出为 JSON 或在 CSV 用于你的分析。.
当你的项目需要时,这是最佳选择 蓬松感十足 以及可靠的基础设施。我们将在我们的 全面评测 Bright Data.
Apify

Apify 是一个云平台,用于 开发刮板 能够执行大规模数据提取。.
他的 TikTok 刮刀 提取详细信息:用户资料、话题标签、视频配乐以及帖子的完整元数据。评论则通过专用的工具“TikTok Comments Scraper”进行提取。.
这是 最灵活的解决方案, ,非常适合在云端自定义数据提取或自动化重复性任务。数据将导出为 JSON 在哪里 CSV 直接在界面中操作。如需了解更多详情,请参阅我们的 全面评测 Apify.
Octoparse
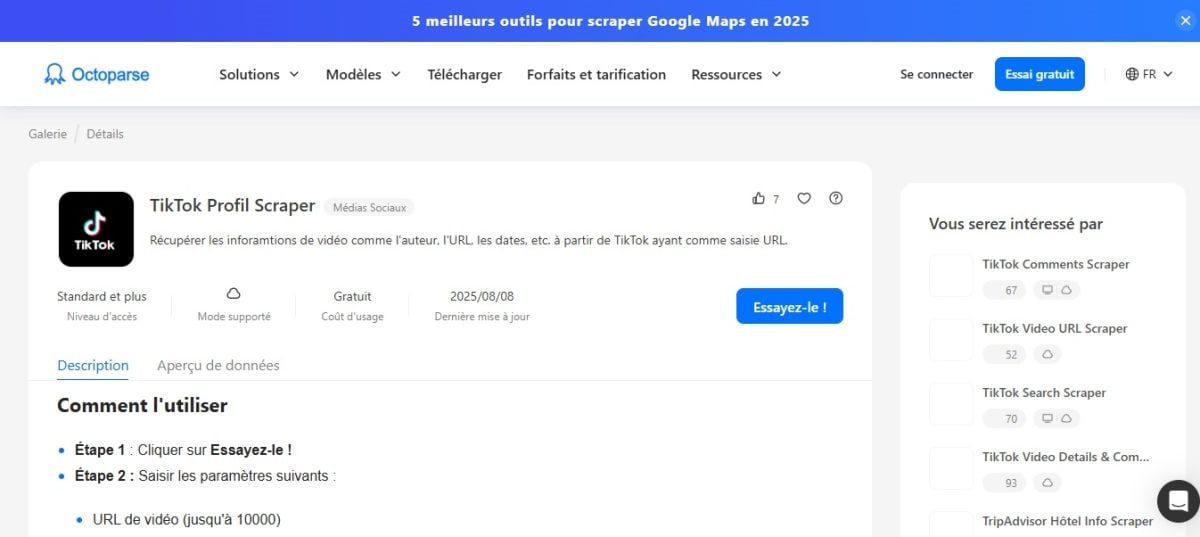
Octoparse 是一个 无代码解决方案 其可视化界面让你只需点击几下即可创建一个数据抓取工具,无需编写任何代码。该工具还提供了一个 模板 TikTok 刮板 开箱即用,之后你可以根据自己的需求进行个性化设置。.
对于……来说,这是最实惠的选择 初学者 希望快速提取数据的人。如需了解更多信息,请阅读我们的 Octoparse 全面评测.
2.使用 Python 浏览代码
这 使用Python进行数据抓取 是一种更 技术性强且可定制, ,这需要具备编程基础。如果你想要一个 全面控制 关于要提取的数据、输出格式(JSON, CSV) 以及请求的频率。以下是具体操作步骤。.
先决条件
首先,安装几个 Python 库:
pip install requests parsel jmespath selenium scrapfly-sdk
该命令安装 .NET Framework 3.0:
- Requests 为了 HTTP 请求.
- Parsel 用于分析HTML内容(XPath选择器)。.
- JMESPath 用于过滤JSON。.
- Selenium 用于管理 JavaScript 页面 如果有必要。.
- scrapfly-sdk, ,ScrapFly的SDK(付费服务,提供1 000个免费积分用于测试),下文将使用该SDK来管理反机器人机制和代理服务器。.
此处采用的方法是通过……从个人资料或视频中提取数据。’JSON分析 隐藏在TikTok页面中。.
TikTok 将这些数据直接注入到页面的 HTML 中,位于 标签内,从而无需调用官方 API。.
步骤 1:分析网络请求
- 打开这些 开发工具 (F12) 你的浏览器。.
- 在 Network, 观察这些 加载请求 当你在 tiktok.com 上浏览个人主页或视频时。.
- 定位数据来源。对于个人主页或视频,该来源是 标签,可在页面源代码(“元素”标签页)中看到。 对于评论,则是发往类似 /api/comment/list/ 这种格式的 URL 的 XHR 请求,可在“网络”标签页中看到。其完整 URL 显示在“头部”标签页中。.
- 对于个人主页或视频,只需使用该页面的URL;对于评论,则使用该端点的URL。.
步骤 2:发送请求并获取响应
一旦确定了来源,请使用 Python 以请求该页面并提取其中包含的JSON数据。.
import requests
from parsel import Selector
import json

url = "https://www.tiktok.com/@pseudo"  请将 # 替换为目标 URL
resp = requests.get(url, headers={
    "User-Agent": "Mozilla/5.0"
})
selector = Selector(resp.text)
data = selector.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
profile = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.user-detail"]["userInfo"]
print(profile)
标签 __UNIVERSAL_DATA_FOR_REHYDRATION__ 包含TikTok注入到个人资料页和视频页中的JSON代码块。该代码块包含个人资料的元数据:关注者数量、关注数量、个人简介和用户ID。该方法借鉴了由 ScrapFly.
步骤3:提取相关数据
然后你可以 过滤 JSON 只保留核心信息:用户名、互动数据、简介。以下是一个使用ScrapFly的示例,适用于 TikTok 帖子 :
from scrapfly import ScrapeConfig, ScrapflyClient
import json, jmespath

SCRAPFLY = ScrapflyClient(key="TA_CLE")
CONFIG = {"asp": True, "country": "US"}

def parse_post(response):
    sel = response.selector
    data = sel.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
    post = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return jmespath.search(
 """{
 id: id,
 desc: desc,
 author: author.{uniqueId, nickname},
        stats: stats
 }""",
 post
    )

async def scrape_posts(urls):
    to_scrape = [ScrapeConfig(url, **CONFIG) for url in urls]
    results = []
    async for resp in SCRAPFLY.concurrent_scrape(to_scrape):
 results.append(parse_post(resp))
    return results
这段代码展示了如何 正确解析 帖子的关键信息:ID、描述、作者和互动数据(喜欢, (评论、浏览量、分享量)。随后,该结果可转换为 CSV 用于你的分析。.
第4步:管理迭代和分页
TikTok的内部API通常每次只返回一小部分结果。若要获取更多评论,你需要使用循环来处理分页 while, ,只要还有数据需要加载,它就会继续向该端点发送请求。.
cursor = 0
all_data = []
while True:
    params = {"count": 20, "cursor": cursor, "aweme_id": post_id}
    resp = requests.get(api_url, params=params)
    data = resp.json()
    comments = data.get("comments", [])
    all_data.extend(comments)
    if not data.get("total") or cursor >= data["total"]:
 break
    cursor += params["count"]
简体代码 :将 api_url 替换为 https://www.tiktok.com/api/comment/list/,将 post_id 替换为视频的 ID。实际上,TikTok 还要求提供从浏览器获取的会话参数,因此建议通过 ScrapFly 或无头浏览器来操作。.
这里利用了该参数 cursor 为了 通过内部端点进行分页 注释。每次迭代都会获取20条结果,直到数据完全耗尽为止。.
为什么要在 TikTok 上报废?
从TikTok收集公开数据有助于做出更明智的决策,无论你从事的是市场营销、数据分析还是研究工作。以下是五个具体应用场景,在这些场景中,提取TikTok数据确实能发挥关键作用:
- 市场分析: 你找到那些 新兴趋势 (热门话题标签、流行音频、小众内容)。通过关注正在崛起的趋势,你可以在某个话题变得饱和之前就发现它。.
- 网红营销: 你可以通过比较相关博主的粉丝数量、他们的 承诺率 实际效果以及帖子的表现,而不是仅凭显示的数字来判断。.
- 情感分析: 你通过收集以下信息来评估人们对一个品牌的认知: 注释 在视频下方,以了解公众反应总体上是积极、消极还是中立的。.
- 学术研究: 通过提取的数据可以研究 社会或文化现象 这些现象在平台上有所体现,并附有量化且可复现的数据样本。.
- 竞争情报: 你通过关注竞争对手的发布频率、有效的内容形式以及 影片 能获得最多点赞和浏览量的。.
在所有这些情况下,都应遵守TikTok的使用条款以及 RGPD 这仍然是你的责任,尤其是在处理与可识别用户相关的信息时。.
常见问题
TikTok 上的网络搜索合法吗?
这是一个需要具体分析的问题。一般来说,从TikTok抓取公开数据本身并不违法,但你必须遵守两点: TikTok 的使用条件, ,这些平台在其《用户使用条款》中禁止自动数据采集,以及诸如 RGPD 在欧洲。.
具体来说,提取公开信息(话题标签、热门话题、汇总统计数据)比收集个人身份数据(电子邮件、可识别身份的个人资料)面临的问题要少。如果你存储了个人数据,则需根据《通用数据保护条例》(GDPR)承担相应责任。如需了解更多详情,请阅读我们关于该条例的文章: 网络搜索的合法性.
有哪些最好的 TikTok 搜索工具和软件?
这完全取决于你的需求和技术能力。.
- 无需编程即可入门: Octoparse 这是最简单的解决方案,拥有直观的图形界面。.
- 针对大宗项目: Bright Data 凭借其内置的代理服务器和防封锁基础设施,表现卓越。.
- 要在云端实现自动化: Apify 提供 TikTok 刮刀 开箱即用,支持导出为 JSON 在哪里 CSV.
如果你更喜欢自己编写代码,, Python 使用诸如 Selenium 或 SDK ScrapFly 能让你更好地掌控提取过程。如需详细对比(价格、优势、局限性),请参阅我们关于 最佳网络搜刮工具.
可以从 TikTok 提取哪些数据?
你可以在TikTok上获取各种各样的公开信息:
- 用户资料:姓名、简介、关注者数量、关注数量、用户ID。.
- 视频和帖子的元数据:描述、时长、发布日期、配乐
- 热门话题标签和趋势
- 参与度统计数据: 喜欢, 分享、评论、浏览量
所有这些数据均以结构化格式返回(JSON),可轻松转换为 CSV 用于你的分析。.
如何绕过 TikTok 的反僵尸保护?
TikTok 采取了多项措施来阻止爬虫,包括分析浏览行为、请求的技术指纹(TLS、请求头、Cookie)以及 IP 地址的信誉评估。.
只要遵循最佳实践,这些防护措施仍可有效管理:
- 使用轮换的住宅代理(数据中心的IP地址很容易被识别出来)。.
- 使用以下方式模拟真实的浏览器 Selenium.
- 添加 请求之间的随机延迟 以避免服务器过载。.
你抓取数据的速度越快,被发现的风险就越大。保持一个合理的速度,既能保护TikTok,也能保障你自己的访问安全。.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA