det web scraping på Instagram er muligt, men platformen blokerer aktivt bots. I 2026, der er to metoder, der fungerer: at bruge en færdiglavet værktøj som Bright Data, Apify Hvor ScrapFly, eller skrive din egen scraper i Python.
På den måde får du offentlige data : profiler, indlæg, Reels, kommentarer eller følgere.

De forskellige metoder til scraping på Instagram
det web scraping er en teknik, der gør det muligt at’Udtræk data automatisk fra en hjemmeside, herunder Instagram. For at scrape Instagram har du to hovedmetoder: at bruge en færdiglavet værktøj, eller skrive din egen kode scraper i Python. Valget afhænger først og fremmest af dit tekniske niveau og det mål, du sigter mod.
1. Brug af webscraping-værktøjer
Hvis du ikke kan programmere, så fortvivl ikke. Der findes Skrabere, der er klar til brug som henter de offentlige data, du har brug for på Instagram, til dig. Du får dine data uden at skulle have tekniske færdigheder, og de kan ofte eksporteres direkte til CSV eller i JSON.
Besøg tre effektive værktøjer for at hente data fra Instagram:
- Bright Data : den mest omfattende, rettet mod store projekter
- Apify : alsidig, med scrapers, der er klar til brug i skyen
- ScrapFly : et API, der er nemt at integrere i din kode
Lyse data
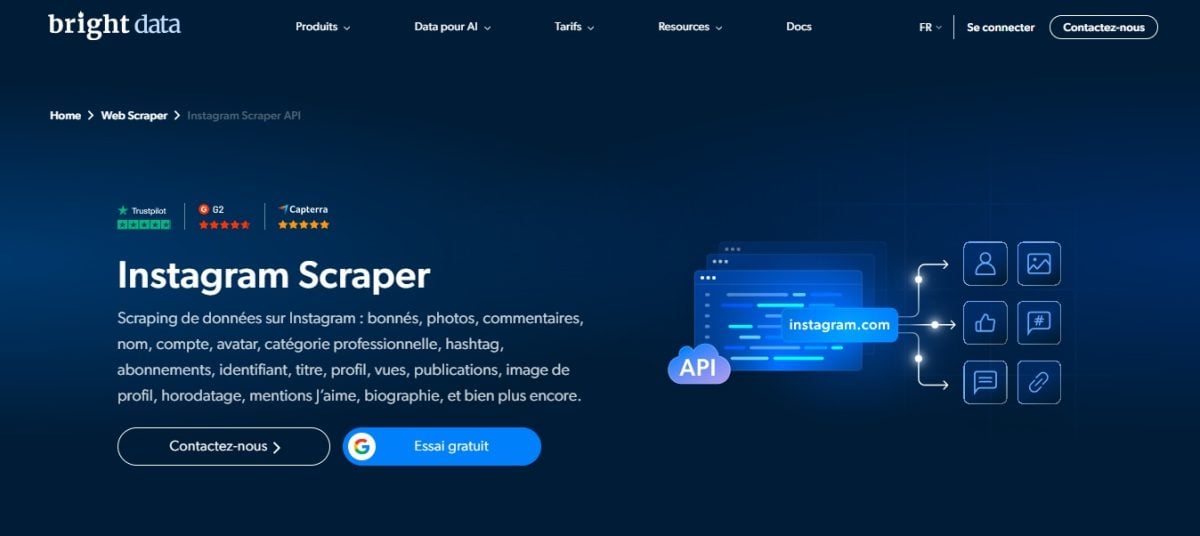
Branchestandard, Bright Data leverer avancerede proxyservere, en indbygget scraping-browser og nogle Specialiserede API'er. Hende Instagram Scraper er udviklet til at gøre det nemmere at udtrække data: profiler, indlæg, hashtags, følgere eller kommentarer. Du angiver URL’erne til de profiler, der skal scrapes, og så får du en fil CSV Hvor JSON gratis. Der findes en gratis plan, så man kan afprøve platformen.
Hvis du vil vide mere, kan du læse vores fuld gennemgang af Bright Data.
Apify
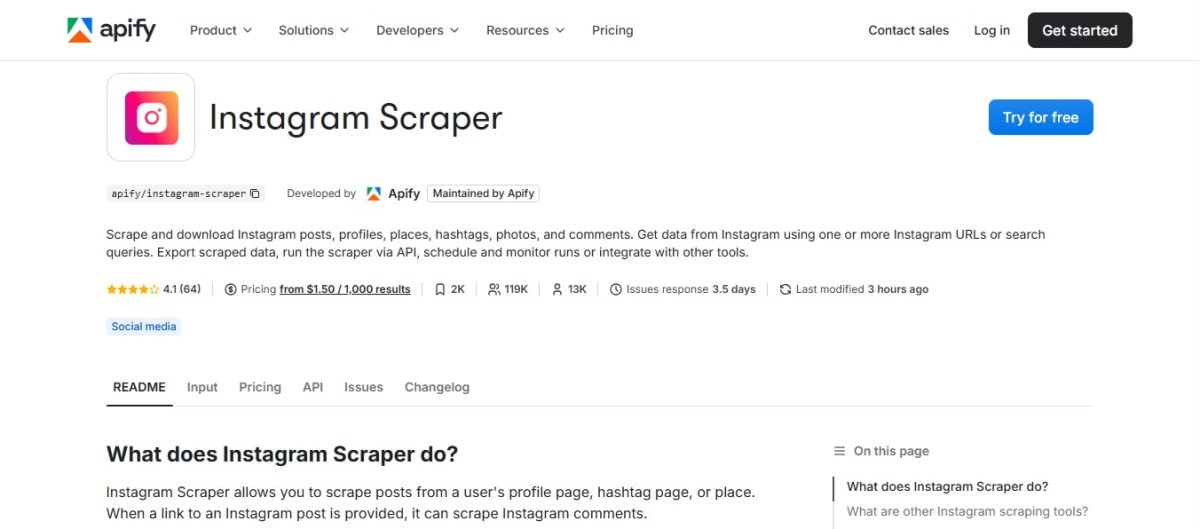
Apify er en platform dedikeret til’kørsel af scrapers i skyen. Det fungerer via "aktører" (Actors), færdiglavede scripts eller scripts, der kan tilpasses efter dine behov. Dens Instagram Scraper Det er nemt at komme i gang med blot et par klik: Du indtaster URL’erne til de profiler eller hashtags, du vil målrette mod, indsamler data om konti, indlæg og Reels, og derefter eksporterer du det hele til CSV Hvor JSON. Der tilbydes en gratis plan til at komme i gang.
Se vores mening om Apify for at se, hvorfor det er velegnet til både udviklere og begyndere.
ScrapFly

ScrapFly er en API til webscraping udviklet til at forenkle dataudtræk fra enhver hjemmeside, herunder Instagram. Den håndterer proxyservere og omgåelse af blokeringer i baggrunden. Vi sætter pris på, at den nemt kan integreres i et Python- eller JavaScript-script uden kompliceret konfiguration. Med et gratis abonnement kan du afprøve API’en, inden du skifter til et betalt abonnement.
Se vores En omfattende guide til scraping-værktøjer for at læse mere.
2. Vælg "hjemmelavede" løsninger med Python
Vil du have en total kontrol til dit projekt? Hvis du har grundlæggende kendskab til programmering, kan du skrive din egen Instagram-scraper i Python. Du kan så trække på Biblioteker der hjælper dig i hvert trin: forespørgsler, sideanalyse, udtræk og eksport af data til CSV eller JSON. Her er de tre vigtigste.
SmukSuppe
BeautifulSoup gør det muligtat analysere HTML-koden fra en webside for at udtrække dataene. Den er nem at gå i gang med og perfekt til grundlæggende analyse. Et simpelt eksempel på, hvordan man analyserer en hentet side:
- from bs4 import BeautifulSoup
- soup = BeautifulSoup(html, « html.parser »)
- meta = soup.find(« meta », property= »og:description »)
Bemærk: Instagram henter en stor del af sit indhold fra JavaScript. BeautifulSoup Det er altså ikke altid nok at gøre det alene, og derfor er de to følgende værktøjer nyttige.
Selen
Selenium er en browser-automatiseringsværktøj, der ofte bruges som supplement til BeautifulSoup. Den simulerer brugerhandlinger (klik, rulning) på siden. Det er meget nyttigt på Instagram, hvor indlæg og profiler indlæses dynamisk.
Dramatiker
Udviklet af Microsoft, Playwright er en et mere moderne alternativ på Selenium. Det giver bedre ydeevne, når du skal automatisere din scraping på Instagram, og vinder stadig større indpas blandt udviklere på grund af sin pålidelighed.
Hvordan skrotter man Instagram i 2026?
Instagram-scraping kræver en grundig metode. Uanset om du bruger et færdigt værktøj eller dit eget Python-script, følger et scraping-projekt altid de samme vigtige trin. Sådan fungerer det, trin for trin.
1. Fastlægge målet og de data, der skal udtrækkes
Start med at præcisere, hvad du vil hente ud fra Instagram. Det kan være antal følgere fra en influencer, de kommentarer under et indlæg, listen over profiler, der følger en konto, eller de hashtags tendensen inden for et bestemt tema. Vær præcis med hensyn til den type data, du sigter mod: at scrape Reels, likes eller offentlige profiler kræver ikke den samme opsætning.
2. Vælg det rigtige værktøj
Enten bruger du en Klar til brug Instagram-scraper som Bright Data Hvor Apify, enten skriver du din egen kode scraper i Python. Til engangsbrug er et værktøj nok. Til automatiseret scraping i stor skala giver koden dig flere styring. Valget afhænger af dine kompetencer, dit budget og projektets omfang.
3. Konfigurer proxyservere og anti-blokering
Instagram blokerer IP-adresser der sender for mange forespørgsler på kort tid: det kaldes hastighedsbegrænsning. Uden beskyttelse bliver din skraber hurtigt skåret over.
Paraden består af proxys, som skifter din IP-adresse ved hver forespørgsel. Med Bright Data, proxy-rotationen styres automatisk via API’en. I Python integrerer du en proxy direkte i din forespørgsel:
- proxies = {
‘http’: ‘http://user:pass@ip:port’,
‘https’: ‘http://user:pass@ip:port’
}
Tilføj også en tidsinterval mellem hver forespørgsel og en user-agent troværdig, så du ikke bliver opdaget. Afhængigt af dine behov og dit budget kan du vælge mellem to typer proxyservere:
- Boliger : mere diskrete, men dyrere
- Datacenter : billigere og hurtigere, men bliver næsten altid blokeret af Instagram
4. Kør scriptet eller værktøjet
Kør din scraper for at indsamle de ønskede data på Instagram. Den gennemsøger offentlige sider, læser HTML-koden eller forespørger en API og returnerer derefter de ønskede oplysninger. Nogle scrapers udnytter en officiel eller uofficiel API, som returnerer data direkte i det ønskede format JSON. Du kan også vedlægge en liste over’Profil-URL'er skal behandles i batcher.
5. Behandling og opbevaring af data
Når dataene er indsamlet, skal de renses, organiseres og gemmes i et format, der kan bruges. De mest almindelige formater er CSV (kan redigeres i Excel), den JSON eller en database. Med en god CSV-fil kan du sortere og filtrere dine profiler, indlæg eller kommentarer på få sekunder.
6. Analysere og fortolke resultaterne
Gennemgå dine data for at udlede konkrete oplysninger. Du kan identificere tendenser, måle’forpligtelse af en profil eller at kortlægge brugernes adfærd i forbindelse med et hashtag. Det er netop dette trin, der forvandler en udtrækning af rådata til virkelig nyttige indsigter med hensyn til dit oprindelige mål.
Hvorfor webscraping på Instagram?
Med næsten 3 milliarder brugere Med sine aktive brugere hver måned er Instagram en sand guldgrube af offentlige data.
Den samme logik gælder i øvrigt også for andre netværk som Facebook Hvor TikTok. Her er de anvendelsesscenarier, hvor Instagram-scraping virkelig gør en forskel.
Konkurrenceovervågning og markedsanalyse
Du henter indlæg, Reels og hashtags de mest effektive elementer i en konkurrentprofil. I praksis skal du identificere tendenser, publiceringsfrekvensen og de formater, der genererer flest kan lide og kommentarer. Disse data hjælper dig med hurtigt at tilpasse din egen strategi.
Influencer-marketing
Det er den mest almindelige anvendelse i erhvervslivet. Du scraber profiler, der bruger et bestemt hashtag eller poster om et bestemt emne. Du henter deres antal følgere, deres forpligtelsesgrad og deres offentlige kontaktoplysninger (arbejds-e-mail, hjemmeside).
API’en eller scraperen returnerer disse data i JSON-format, klar til filtrering.
Akademisk forskning og dataanalyse
Forskere gennemsøger Instagram til deres sociologiske undersøgelser, eller’sentimentanalyse. Ved at indsamle tusindvis af kommentarer og billedtekster via web-scrapere undersøger de brugernes adfærd i stor skala. Formatet JSON Hvor CSV gør det derefter lettere at foretage statistiske analyser.
Samling og centralisering af indhold
Du kan automatisere indsamlingen af offentlige data (indlæg, Reels, profiler) for at samle dem i ét samlet interface. Det er nyttigt for et brand, der ønsker at holde øje med sit fællesskab, eller for et medie, der samler tendenser efter hashtag.
Under alle omstændigheder må du kun røre ved offentlige data og du strukturerer dem, så du sparer en masse tid i forhold til en manuel indsamling.
Ofte stillede spørgsmål
Hvad er forskellen på at bruge et scraping-værktøj (som Bright Data eller Apify) og at kode sin egen scraper i Python?
Værktøjer som Bright Data Hvor Apify er klar til brug. Du får adgang til et grafisk brugergrænseflade, et dedikeret API, kundesupport og direkte eksport til CSV eller JSON.
Det er den ideelle løsning, hvis du ikke vil programmere. Budgetmæssigt er et færdigt værktøj dyrere end en hjemmelavet scraper, men du sparer enormt meget tid, da alt allerede er konfigureret (proxyservere, IP-rotation, håndtering af blokeringer).
At programmere i Python giver dig derimod en total kontrol og maksimal fleksibilitet. Du vælger selv præcis, hvilke data der skal udtrækkes, fra hvilke profiler og i hvilket format. Denne tilgang kræver dog reelle tekniske kompetencer.
Kan man scrape private data eller private konti på Instagram?
Nix. Instagrams brugsbetingelser forbyder enhver uautoriseret indsamling af data, og ingen scrapers kan få adgang til private konti. Scraping er derfor begrænset til offentlige data: åbne profiler, opslag og Reels, der kan ses uden at være logget ind.
Hvis du forsøger at omgå beskyttelsen af en privat konto, risikerer du at blive retsforfulgt: det skal du under alle omstændigheder undgå.
Hvorfor er det vigtigt at bruge proxyer til at scrape Instagram?
instagram begrænser antallet af forespørgsler pr. IP-adresse. Hvis en og samme adresse sender for mange forespørgsler på kort tid, bliver den hurtigt blokeret.
Proxyservere bruges til:
- At skifte mellem flere IP-adresser for at simulere en menneskehandel
- Omgå automatiske spærringer fra Instagram
- Undgå at blive opdaget som en bot
De er derfor afgørende for at sikre pålidelighed og holdbarhed af din scraper, især i stor skala.
Er web scraping fra Instagram lovligt i 2026?
Spørgsmålet om, hvorvidt scraping er lovligt, er stadig et gråzone. Det afhænger helt af, hvilken type data du henter:
- Indsamling af offentlige data at bruge tjenesten uden at logge ind på en Instagram-konto tolereres generelt, selvom Instagrams brugsbetingelser forbyder enhver form for automatiseret indsamling uden tilladelse. Under alle omstændigheder, respekterer privatlivets fred brugere.
- Scrape nogle personlige eller beskyttede oplysninger er forbudt og kan medføre retsforfølgelse
I USA handler sagen om hiQ v. LinkedIn bekræftede i 2022 at scraping af offentlige data ikke udgør ulovlig adgang i henhold til CFAA.
Men vær forsigtig: hiQ blev i sidste ende dømt på andre grundlag ved den endelige afgørelse. Den juridiske ramme beskytter altså først og fremmest adgangen til offentlige data, uden at det er en fuldstændig grønt lys.
I Europa er RGPD medfører strenge krav, så snart man håndterer personoplysninger, selvom de er offentlige. Det gælder stadig, at man skal handle på en måde, der ansvarlig, gennemsigtig og respektfuld om privatlivets fred.
Uanset om det er en færdig løsning eller et hjemmelavet Python-script, så mangler der ikke metoder til at scrape Instagram. Det er op til dig at vælge den, der passer bedst til dine behov og dit budget. Og hvis du bruger andre effektive værktøjer til at scrape Instagram, så del dem gerne i kommentarerne.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA