Le web scraping sur Instagram est possible, mais le réseau bloque activement les bots. En 2026, deux approches fonctionnent : utiliser un outil clé en main comme Bright Data, Apify ou ScrapFly, ou coder ton propre scraper en Python.
Tu récupères ainsi des données publiques : profils, posts, reels, commentaires ou followers.

Les différentes méthodes pour faire du scraping sur Instagram
Le web scraping est une technique qui permet d’extraire automatiquement des données depuis un site web, dont Instagram. Pour scraper Instagram, tu as deux grandes approches : utiliser un outil clé en main, ou coder ton propre scraper en Python. Le choix dépend surtout de ton niveau technique et de l’échelle visée.
1. Utiliser des outils de web scraping
Si tu ne sais pas coder, pas de panique. Il existe des scrapers prêts à l’emploi qui récupèrent pour toi les données publiques dont tu as besoin sur Instagram. Tu obtiens tes données sans compétences techniques, souvent exportables directement en CSV ou en JSON.
Voici trois outils efficaces pour extraire des données sur Instagram :
- Bright Data : le plus complet, orienté grande échelle
- Apify : polyvalent, avec des scrapers prêts à lancer dans le cloud
- ScrapFly : une API simple à intégrer dans ton code
Bright Data
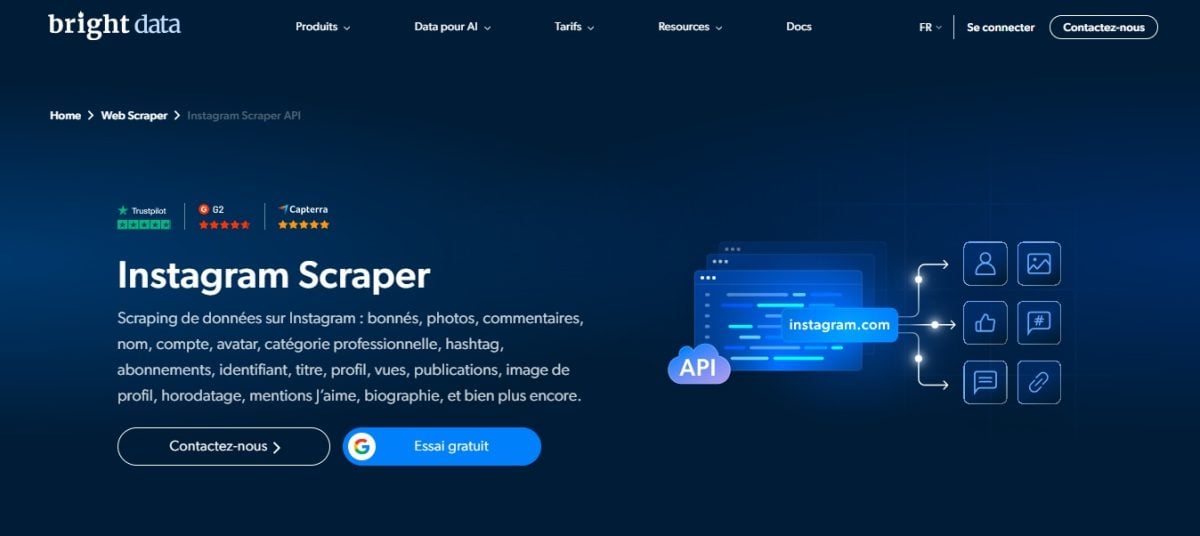
Référence du secteur, Bright Data fournit des proxies avancés, un navigateur de scraping intégré et des API spécialisées. Son Instagram Scraper est pensé pour simplifier l’extraction de données : profils, posts, hashtags, followers ou commentaires. Tu fournis les URLs des profils à scraper, et tu récupères un fichier CSV ou JSON propre. Un plan gratuit est disponible pour tester la plateforme.
Pour en savoir plus, consulte notre avis complet sur Bright Data.
Apify
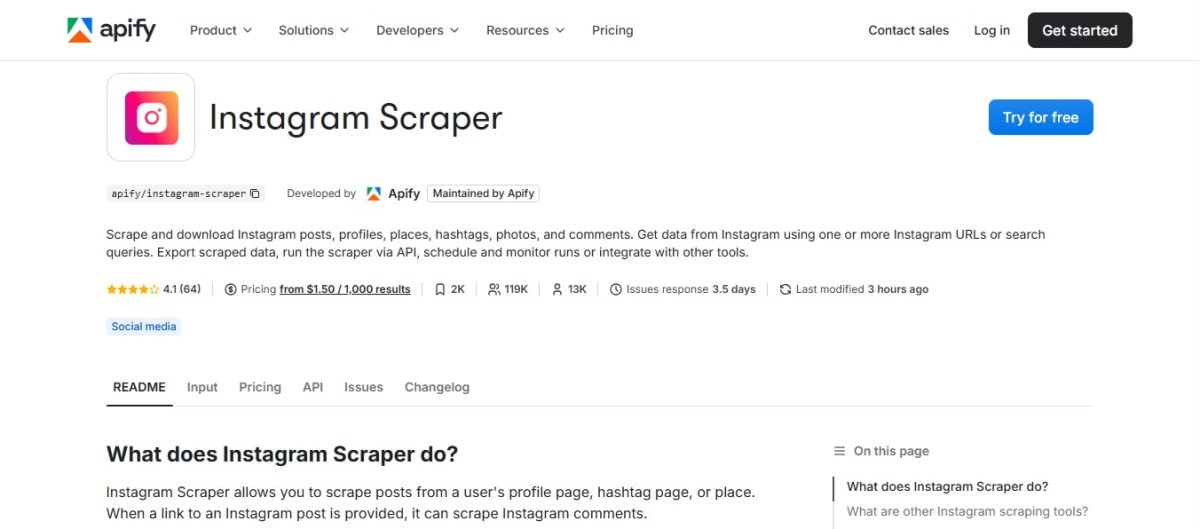
Apify est une plateforme dédiée à l’exécution de scrapers dans le cloud. Elle fonctionne via des « acteurs » (Actors), des scripts pré-construits ou personnalisables selon tes besoins. Son Instagram Scraper se lance en quelques clics : tu fournis les URLs des profils ou des hashtags ciblés, tu collectes des données sur des comptes, des posts, des reels, puis tu exportes le tout en CSV ou JSON. Un plan gratuit est proposé pour démarrer.
Consulte notre avis sur Apify pour voir en quoi il convient aux développeurs comme aux débutants.
ScrapFly

ScrapFly est une API de web scraping conçue pour simplifier l’extraction de données sur n’importe quel site, Instagram compris. Elle gère les proxies et le contournement des blocages en arrière-plan. On l’apprécie pour sa facilité d’intégration dans un script Python ou JavaScript, sans configuration complexe. Un plan gratuit permet de tester l’API avant de passer à un abonnement payant.
Consulte notre guide complet sur les outils de scraping pour aller plus loin.
2. Opter pour des solutions « faites maison » avec Python
Tu veux un contrôle total sur ton projet ? Si tu as des bases en développement, tu peux coder ton propre scraper Instagram en Python. Tu t’appuies alors sur des bibliothèques qui t’aident à chaque étape : requêtes, analyse de la page, extraction, export des données en CSV ou JSON. Voici les trois principales.
BeautifulSoup
BeautifulSoup permet d’analyser le HTML d’une page web pour en extraire les données. Elle est simple à prendre en main et parfaite pour de l’analyse de base. Un exemple minimal pour parser une page récupérée :
- from bs4 import BeautifulSoup
- soup = BeautifulSoup(html, « html.parser »)
- meta = soup.find(« meta », property= »og:description »)
À noter : Instagram charge une grande partie de son contenu en JavaScript. BeautifulSoup seul ne suffit donc pas toujours, d’où l’intérêt des deux outils suivants.
Selenium
Selenium est un outil d’automatisation de navigateur, souvent utilisé en complément de BeautifulSoup. Il simule des actions d’utilisateur (cliquer, scroller) sur la page. C’est très utile sur Instagram, qui charge ses posts et ses profils de façon dynamique.
Playwright
Développé par Microsoft, Playwright est une alternative plus moderne à Selenium. Il offre de meilleures performances pour automatiser ton scraping sur Instagram et gagne du terrain chez les développeurs pour sa fiabilité.
Comment faire du scraping Instagram en 2026 ?
Scraper Instagram demande une vraie méthodologie. Que tu passes par un outil clé en main ou par ton propre script Python, un projet de scraping suit toujours les mêmes étapes clés. Voici comment ça marche, pas à pas.
1. Définir l’objectif et les données à extraire
Commence par préciser ce que tu veux extraire sur Instagram. Ça peut être le nombre de followers d’un influenceur, les commentaires sous un post, la liste des profils abonnés à un compte ou les hashtags tendance d’une thématique. Sois précis sur le type de données visé : scraper des reels, des likes ou des profils publics ne demande pas la même configuration.
2. Choisir l’outil adapté
Soit tu utilises un scraper Instagram prêt à l’emploi comme Bright Data ou Apify, soit tu codes ton propre scraper en Python. Pour un usage ponctuel, un outil suffit. Pour du scraping à grande échelle et automatisé, le code te donne plus de contrôle. Le choix dépend de tes compétences, de ton budget et de l’échelle du projet.
3. Configurer les proxys et l’anti-blocage
Instagram bloque les adresses IP qui envoient trop de requêtes en peu de temps : c’est ce qu’on appelle le rate limiting. Sans protection, ton scraper se fait couper rapidement.
La parade, ce sont les proxys, qui font tourner ton adresse IP à chaque requête. Avec Bright Data, la rotation de proxies est gérée automatiquement via l’API. En Python, tu intègres un proxy directement dans ta requête :
- proxies = {
‘http’: ‘http://user:pass@ip:port’,
‘https’: ‘http://user:pass@ip:port’
}
Ajoute aussi un délai entre chaque requête et un user-agent crédible pour ne pas te faire repérer. Selon tes besoins et ton budget, tu as le choix entre deux types de proxys :
- Résidentiels : plus discrets, mais plus chers
- Datacenter : moins chers et plus rapides, mais quasi systématiquement bloqués par Instagram
4. Exécuter le script ou l’outil
Lance ton scraper pour récupérer les données ciblées sur Instagram. Il parcourt les pages publiques, lit le HTML ou interroge une API, puis remonte les informations demandées. Certains scrapers exploitent une API officielle ou non officielle, ce qui te renvoie directement des données propres au format JSON. Tu peux aussi fournir une liste d’URLs de profils à traiter en lot.
5. Traiter et stocker les données
Une fois collectées, les données doivent être nettoyées, organisées et stockées dans un format exploitable. Les plus courants sont le CSV (ouvrable dans Excel), le JSON ou une base de données. Un bon fichier CSV te permet de trier et filtrer tes profils, posts ou commentaires en quelques secondes.
6. Analyser et interpréter les résultats
Examine tes données pour en tirer des informations concrètes. Tu peux identifier des tendances, mesurer l’engagement d’un profil ou repérer le comportement des utilisateurs autour d’un hashtag. C’est cette étape qui transforme une extraction de données brutes en insights réellement utiles pour ton objectif de départ.
Pourquoi faire du web scraping sur Instagram ?
Avec près de 3 milliards d’utilisateurs actifs chaque mois, Instagram est une vraie mine de données publiques.
La même logique s’applique d’ailleurs sur d’autres réseaux comme Facebook ou TikTok. Voici les cas d’usage où scraper Instagram change vraiment la donne.
La veille concurrentielle et l’analyse de marché
Tu extrais les posts, les reels et les hashtags les plus performants d’un profil concurrent. En pratique, tu repères les tendances, le rythme de publication et les formats qui génèrent le plus de likes et de commentaires. Ces données t’aident à ajuster ta propre stratégie rapidement.
Le marketing d’influence
C’est l’usage business le plus courant. Tu scrapes les profils qui utilisent un hashtag précis ou qui publient sur une thématique donnée. Tu récupères leur nombre de followers, leur taux d’engagement et leurs coordonnées publiques (email pro, site).
L’API ou le scraper te retourne ces données au format JSON, prêtes à filtrer.
La recherche académique et l’analyse de données
Les chercheurs scrapent Instagram pour leurs études sociologiques ou l’analyse de sentiments. En récupérant des milliers de commentaires et de légendes via des scrapers, ils étudient les comportements des utilisateurs à grande échelle. Le format JSON ou CSV facilite ensuite le traitement statistique.
L’agrégation et la centralisation de contenus
Tu peux automatiser la collecte de données publiques (posts, reels, profils) pour les centraliser dans une seule interface. Utile pour une marque qui veut surveiller sa communauté, ou pour un média qui agrège des tendances par hashtag.
Dans tous les cas, tu ne touches qu’à des données publiques et tu les structures pour gagner un temps considérable sur une collecte manuelle.
FAQ
Quelle est la différence entre utiliser un outil de scraping (comme Bright Data ou Apify) et coder son propre scraper en Python ?
Les outils comme Bright Data ou Apify sont prêts à l’emploi. Tu profites d’une interface graphique, d’une API dédiée, d’un support client et d’un export direct en CSV ou JSON.
C’est la solution idéale si tu ne veux pas coder. Côté budget, un outil clé en main revient plus cher qu’un scraper maison, mais tu gagnes énormément de temps puisque tout est déjà configuré (proxies, rotation d’IP, gestion des blocages).
Coder en Python, à l’inverse, te donne un contrôle total et une flexibilité maximale. Tu choisis exactement quelles données extraire, sur quels profils et dans quel format. Cette approche demande toutefois de vraies compétences techniques.
Peut-on scraper des données privées ou des comptes privés sur Instagram ?
Non. Les CGU d’Instagram interdisent toute collecte de données non autorisée, et aucun scraper ne peut accéder aux comptes privés. Le scraping reste donc limité aux données publiques : profils ouverts, publications et reels visibles sans connexion.
Tenter de contourner la protection d’un compte privé t’expose à des poursuites juridiques : à éviter absolument.
Pourquoi est-il crucial d’utiliser des proxys pour scraper Instagram ?
Instagram limite le nombre de requêtes par IP. Si une même adresse envoie trop de demandes en peu de temps, elle est rapidement bloquée.
Les proxys interviennent pour :
- Faire tourner plusieurs IP pour simuler un trafic humain
- Contourner les blocages automatiques d’Instagram
- Éviter d’être détecté comme un bot
Ils sont donc essentiels pour garantir la fiabilité et la durabilité de ton scraper, surtout à grande échelle.
Le web scraping d’Instagram est-il légal en 2026 ?
La légalité du scraping reste une zone grise. Tout dépend de la nature des données que tu récupères :
- Scraper des données publiques sans te connecter à un compte Instagram est généralement toléré, même si les CGU d’Instagram interdisent toute collecte automatisée sans autorisation. Dans tous les cas, respecte la vie privée des utilisateurs.
- Scraper des données privées ou protégées est interdit et passible de poursuites
Aux États-Unis, l’affaire hiQ v. LinkedIn a confirmé en 2022 que scraper des données publiques ne constitue pas un accès illégal au sens du CFAA.
Attention toutefois : hiQ a fini par être condamnée sur d’autres motifs lors du règlement final. Le cadre juridique protège donc surtout l’accès aux données publiques, sans être un feu vert total.
En Europe, le RGPD ajoute une contrainte forte dès que tu manipules des données personnelles, même publiques. Le mot d’ordre reste d’agir de façon responsable, transparente et respectueuse de la vie privée.
Solution prête à l’emploi ou script Python maison, les méthodes de scraping Instagram ne manquent pas. À toi de choisir celle qui colle le mieux à tes besoins et à ton budget. Et si tu utilises d’autres outils efficaces pour scraper Instagram, partage-les en commentaire.





 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA