Scraper Facebook en 2025, c’est faisable, mais plus compliqué qu’avant. Facebook bloque activement les scrapers, ce qui rend les outils dédiés comme Bright Data ou Apify bien plus fiables qu’une solution maison en Python.
Voici les méthodes qui fonctionnent vraiment, ce que tu peux extraire et le cadre légal à connaître avant de te lancer.

Les différentes méthodes pour faire du scraping sur Facebook
Le web scraping est un processus automatisé qui extrait des données depuis des sites web. Sur Facebook, tu as deux grandes options : utiliser un outil prêt à l’emploi, ou développer ta propre solution avec des bibliothèques de programmation. Le choix dépend de ton niveau technique et du volume de données que tu veux récupérer.
1. Utiliser des outils de web scraping
Les outils de scraping s’adressent à celles et ceux qui n’ont pas de compétences en programmation. Ce sont des solutions clé en main qui permettent d’extraire des données en quelques clics. Pour Facebook, trois solutions se démarquent : Bright Data, Apify et Octoparse.
| Outil | Niveau technique | Ce qu’il scrape sur Facebook | Prix d’entrée |
|---|---|---|---|
| Bright Data | Intermédiaire (API) | Pages, groupes, publications publiques, profils | Tarification à l’usage, essai gratuit disponible |
| Apify | Débutant à intermédiaire | Pages, posts, commentaires, reels, marketplace | Tarification à l’usage, essai gratuit disponible |
| Octoparse | Débutant (sans code) | Données publiques de pages et profils | Version gratuite limitée disponible |
Bright Data
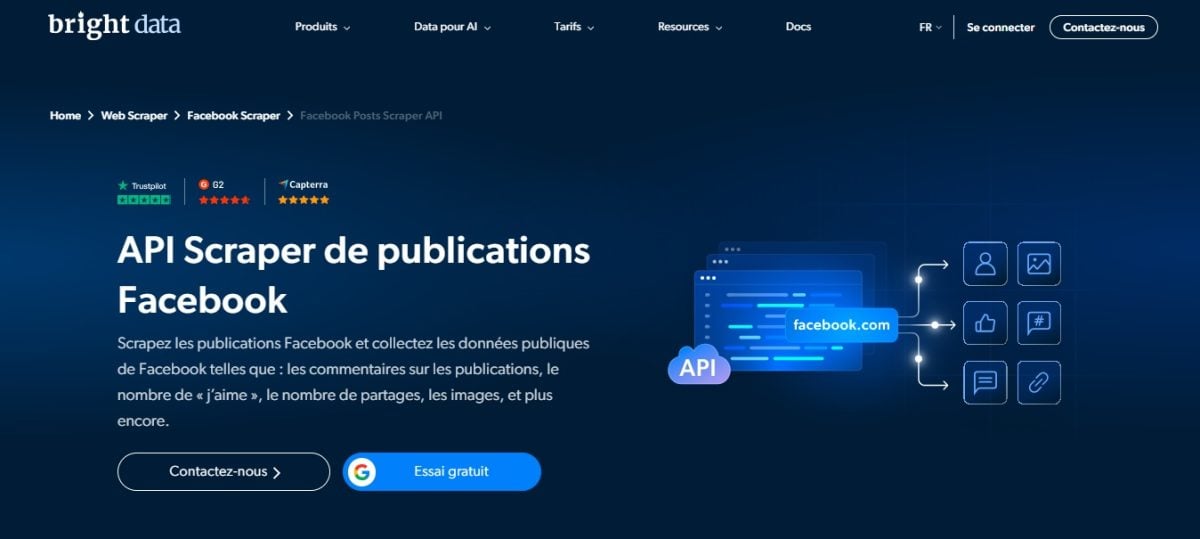
Bright Data combine réseau de proxies, navigateur de scraping et API en une seule plateforme. La rotation de proxies réduit fortement le risque de blocage par Facebook, ce qui est un avantage décisif.
Son Facebook Scraper API est pensé pour ça : tu lui donnes une URL de page ou de groupe, et il te retourne des données structurées au format JSON ou CSV. Il gère seul le contournement des protections anti-bot et l’analyse du code.
Découvre notre avis complet sur Bright Data pour aller plus loin.
Apify

Apify est une plateforme qui propose des solutions pré-construites appelées « Actors ». Son outil phare, le Facebook Pages Scraper, collecte les données de pages publiques : nom, nombre de likes, publications, commentaires et réactions. D’autres Actors ciblent les posts, les groupes ou le Facebook Marketplace.
Consulte notre avis complet sur Apify pour en savoir plus.
Octoparse
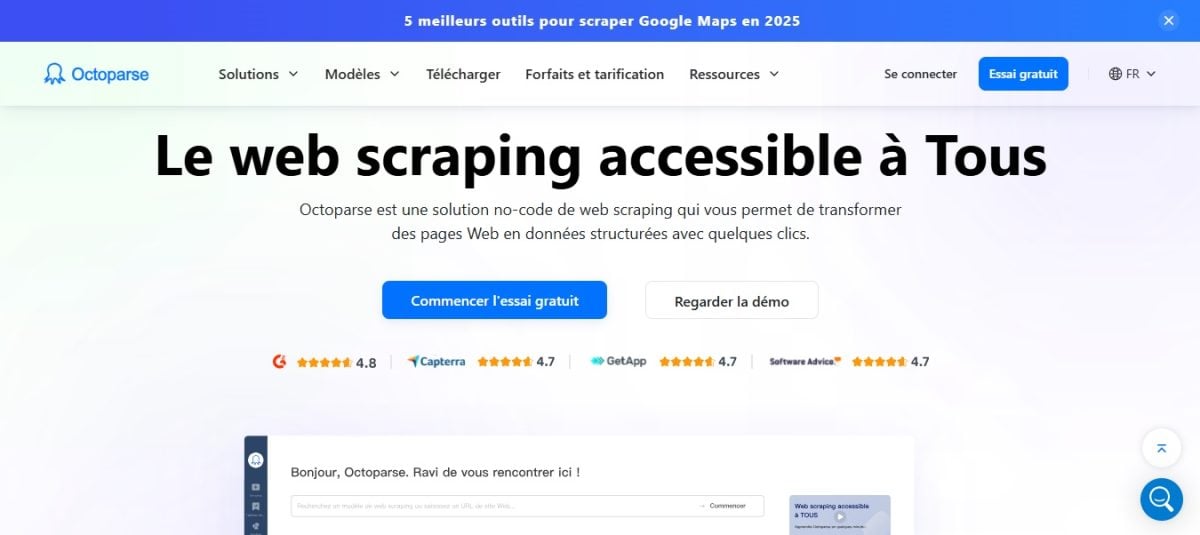
Octoparse permet de faire du scraping sans code grâce à une interface visuelle intuitive. Sa fonctionnalité dédiée à Facebook extrait les données publiques d’une page ou d’un profil sans écrire une seule ligne de code. C’est le choix idéal si tu n’as aucune compétence technique et que tu veux un résultat rapide.
On t’explique toutes les fonctionnalités dans notre avis complet sur Octoparse.
2. Opter pour une solution maison avec Python
Tu veux tout contrôler ? Tu peux créer ton propre scraper Facebook en Python. La méthode la plus fiable combine un navigateur headless et une bibliothèque d’analyse HTML. Un navigateur headless simule un utilisateur réel, ce qui permet de gérer les interactions dynamiques de Facebook comme le défilement infini qui charge de nouveaux posts.
Concrètement, le combo Selenium + BeautifulSoup ouvre les pages Facebook comme le ferait un humain, attend le chargement du contenu, puis extrait les données vers un fichier JSON ou CSV.
- Selenium pilote le navigateur pour interagir avec la page : cliquer, défiler, attendre.
- BeautifulSoup analyse ensuite le code HTML et récupère les informations voulues.
Voici un squelette de script minimal pour te lancer :
from selenium import webdriver
from bs4 import BeautifulSoup

driver = webdriver.Chrome()
driver.get("https://www.facebook.com/nom-de-la-page")

soup = BeautifulSoup(driver.page_source, "html.parser")
for post in soup.find_all("div", {"role": "article"}):
    print(post.get_text())

driver.quit()
Attention, la réalité est plus rude que le code. Facebook exige souvent une connexion, détecte les bots et limite le nombre de requêtes automatisées. Sans proxies rotatifs ni gestion des CAPTCHAs, ton scraper maison sera vite bloqué. C’est là que les outils dédiés reprennent l’avantage.
Que peut-on scraper sur Facebook ?
Le scraping sur Facebook te permet de récupérer uniquement des données publiques. Voici les types de contenus accessibles :
- Pages publiques : nom de la page, nombre de likes et d’abonnés, texte des posts, commentaires, partages et réactions.
- Groupes publics : nom du groupe, description, nombre de membres et publications visibles sans être membre.
- Profils publics : biographie, ville, liste d’amis si elle est publique, et publications publiques.
- Événements et Reels : titre, date, lieu et statistiques d’engagement visibles publiquement.
Un bon scraper récupère l’ensemble de ces éléments et te les livre dans un format structuré (CSV ou JSON), directement exploitable pour tes analyses. Un résultat typique inclut l’identifiant du post, le texte, la date, le nombre de likes, les réactions et les commentaires.
Les informations privées comme les messages, les groupes fermés ou les profils verrouillés restent hors de portée. C’est une règle technique, mais aussi une question de respect des données personnelles.
Comment faire du web scraping sur Facebook en 2025 ?
Avec un outil dédié comme Bright Data ou Apify, un projet de scraping Facebook se déroule en quatre étapes.
1. Choisir le bon scraper selon ta cible
Commence par identifier ce que tu veux extraire. Les scrapers sont souvent spécialisés par type de contenu :
- Facebook Posts Scraper : récupère les publications d’une page (texte, date, likes, réactions, nombre de commentaires).
- Facebook Pages Scraper : extrait les infos d’une page business (nom, catégorie, adresse, avis).
- Facebook Profile Scraper : collecte les données d’un profil public.
- Facebook Groups Scraper : cible les posts et discussions d’un groupe.
Sur Apify, tu choisis l’acteur dans le store. Sur Bright Data, tu sélectionnes le Facebook Scraper API correspondant à ta cible.
2. Renseigner l’URL de la page ou du groupe
L’outil a besoin de l’URL exacte de ta cible sur facebook.com. Copie-la directement depuis la barre d’adresse de ton navigateur :
- Pour une page : https://www.facebook.com/nomdelapage
- Pour un groupe : ouvre le groupe, clique sur son nom, puis copie le lien de type https://www.facebook.com/groups/id
Ensuite, ajuste les options : nombre de posts à récupérer, plage de dates, inclusion des commentaires et des réactions. Plus tu limites le périmètre, plus l’extraction est rapide.
3. Lancer la collecte de données
Clique sur Start pour démarrer. L’outil gère seul les parties techniques : rotation des proxies, contournement de la détection anti-scraping et gestion des limitations imposées par Facebook. C’est justement là qu’un scraper dédié fait la différence par rapport à une solution maison.
Le temps de traitement dépend du volume : quelques secondes pour une poignée de publications, plusieurs minutes pour un gros historique.
4. Exporter les données au bon format
Une fois la collecte terminée, tu exportes tout en un clic. Choisis le format selon ton usage :
- CSV ou Excel : idéal pour trier et analyser dans un tableur.
- JSON : parfait si tu veux réinjecter les données dans ton propre code ou une base de données.
Un résultat typique contient l’identifiant du post, le texte, la date de publication, le nombre de likes, les réactions et les commentaires. Tu obtiens une structure propre, directement exploitable.
Pourquoi faire du scraping sur Facebook ?
Le scraping te donne accès à des données publiques que tu ne pourrais pas collecter à la main sur des milliers de publications. Voici les cas d’usage les plus courants et légitimes :
- Analyse de la concurrence : tu surveilles les pages Facebook de tes concurrents pour décortiquer leur stratégie de contenu. Tu repères quels formats de posts génèrent le plus d’engagement, sans passer des heures à tout relever manuellement.
- Veille et analyse de sentiment : collecter les posts et les commentaires autour d’une marque ou d’un événement te permet de mesurer l’opinion générale et de suivre l’évolution d’une campagne dans le temps.
- Recherche académique et scientifique : les chercheurs exploitent les données Facebook pour des études sociologiques ou linguistiques à grande échelle, afin d’observer la diffusion d’une information ou l’évolution d’un vocabulaire.
- Analyse de performance de contenu : si tu gères plusieurs pages, tu compares tes propres posts pour identifier les formats qui fonctionnent (image, Reels, texte) et ajuster ta ligne éditoriale sur des chiffres concrets.
FAQ
Est-il légal de faire du web scraping sur Facebook ?
La légalité du scraping reste une zone grise juridique. Sur le principe, collecter des données publiques n’est pas interdit par la loi. Le problème vient d’ailleurs : les conditions d’utilisation de Meta interdisent explicitement la collecte automatisée de données, ce qui signifie que scraper Facebook viole ses CGU.
Concrètement, tu risques deux choses : la suspension ou la résiliation de ton compte, et des poursuites civiles. Meta a déjà attaqué des services comme Bright Data en justice pour scraping, même si le résultat de ces procès reste nuancé.
En Europe, le RGPD s’ajoute à l’équation. Une donnée reste une donnée personnelle même quand elle est publiquement accessible, dès lors qu’elle identifie quelqu’un. Tu dois donc minimiser la collecte, sécuriser les données et rester dans un usage acceptable comme la veille concurrentielle anonymisée ou la recherche.
Comment scraper Facebook sans utiliser l’API ?
Tu peux créer un scraper Facebook sur mesure en Python, sans passer par une API officielle, mais cela demande de vraies compétences techniques. Attends-toi à plusieurs obstacles : Facebook exige souvent une connexion, détecte les robots et limite le nombre de requêtes automatisées. Prévoir des proxies devient vite indispensable pour éviter le blocage.
Quelle est la meilleure bibliothèque Python pour scraper Facebook ?
Le duo Selenium (pour simuler un navigateur) et BeautifulSoup (pour analyser le HTML) reste la meilleure option maison en Août 2026. Selenium charge le contenu dynamique, BeautifulSoup extrait ensuite les données comme les posts, les likes ou les commentaires.
Existe-t-il des outils gratuits pour scraper Facebook ?
Bright Data, Octoparse et Apify proposent tous des essais gratuits pour tester leurs fonctionnalités avant de prendre un abonnement. Ces versions gratuites restent limitées en volume de données : elles suffisent pour un premier test, mais un usage sérieux passe vite par une offre payante.
Comment extraire des données de groupes Facebook ?
La plupart des outils de scraping permettent d’extraire des données de groupes publics. Les groupes privés restent inaccessibles. Avec des scrapers dédiés comme Facebook Scraper (Bright Data) ou Facebook Pages Scraper (Apify), la marche à suivre est simple :
- Récupère l’URL du groupe depuis ton navigateur (format : https://www.facebook.com/groups/…).
- Colle cette URL dans l’outil.
- Configure les champs voulus : publications, dates, réactions.
- Lance l’extraction et exporte le résultat en CSV ou JSON.
Scraper Facebook en 2025 reste donc tout à fait possible. Que tu sois débutant avec un outil sans code comme Octoparse, ou développeur aguerri qui préfère coder sa solution, il existe une approche adaptée à ton profil et à tes besoins.
Tu as testé une autre méthode ? Partage ton expérience ou pose tes questions en commentaires.







 Français