Extraer datos de Facebook en 2026 es factible, pero más complicado que antes. Facebook bloquea activamente los programas de extracción de datos, lo que hace que las herramientas específicas como Bright Data Donde Apify mucho más fiables que una solución casera en Python.
Estos son los métodos que realmente funcionan, lo que puedes sacar de ellos y el marco jurídico Lo que debes saber antes de lanzarte.

Diferentes métodos de scraping en Facebook
la raspado web es un proceso automatizado que extrae datos desde páginas web. En Facebook, tienes dos opciones principales: utilizar un herramienta lista para usar, o desarrollar tu propia solución con bibliotecas de programación. La elección depende de tu nivel técnico y del volumen de datos que quieras recuperar.
1. Utilización de herramientas de web scraping
Las herramientas de scraping están dirigidas a aquellas personas que no tienen sin conocimientos de programación. Se trata de soluciones llave en mano que permiten:’extraer datos con solo unos clics. En el caso de Facebook, destacan tres soluciones: Bright Data, Apify y Octoparse.
| Herramienta | Nivel técnico | Lo que recopila en Facebook | Precio de la entrada |
|---|---|---|---|
| Bright Data | Intermedio (API) | Páginas, grupos, publicaciones públicas, perfiles | Tarificación por uso, prueba gratuita disponible |
| Apify | Nivel principiante a intermedio | Páginas, publicaciones, comentarios, Reels, Marketplace | Tarificación por uso, prueba gratuita disponible |
| Octoparse | Principiante (sin código) | Datos públicos de páginas y perfiles | Hay disponible una versión gratuita limitada |
Bright Data
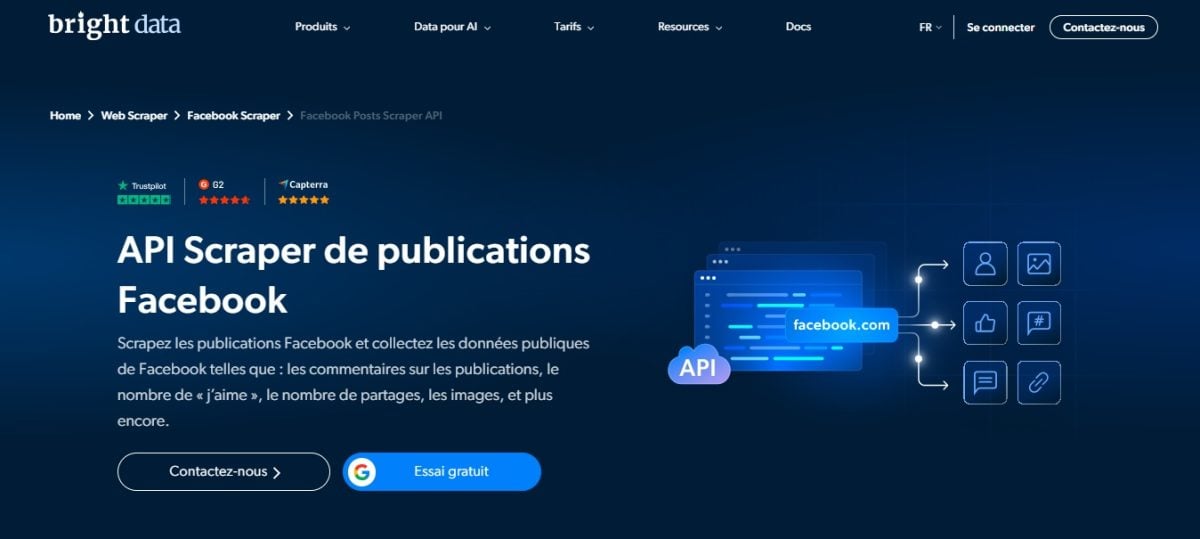
Bright Data combina red de proxies, navegador de raspado y API en una única plataforma. La rotación de apoderados reduce considerablemente el riesgo de que Facebook lo bloquee, lo cual supone una ventaja decisiva.
Su Facebook Scraper API está pensado para eso: le das una URL de una página o de un grupo, y te devuelve datos estructurados en formato JSON Donde CSV. Se encarga por sí solo de sortear las protecciones contra bots y de analizar el código.
Descubre nuestro reseña completa sobre Bright Data Para profundizar en el tema.
Apify

Apify es una plataforma que ofrece soluciones prediseñadas denominadas « Actors ".
Su herramienta estrella, el Facebook Pages Scraper, recopila la información de las páginas públicas: nombre, categoría, datos de contacto, número de «Me gusta» y de seguidores, y valoración.
otros Actors se dirigen a los publicaciones, la comentarios, la grupos donde el Facebook Marketplace.
Echa un vistazo a nuestro reseña completa sobre Apify para saber más.
Octoparse
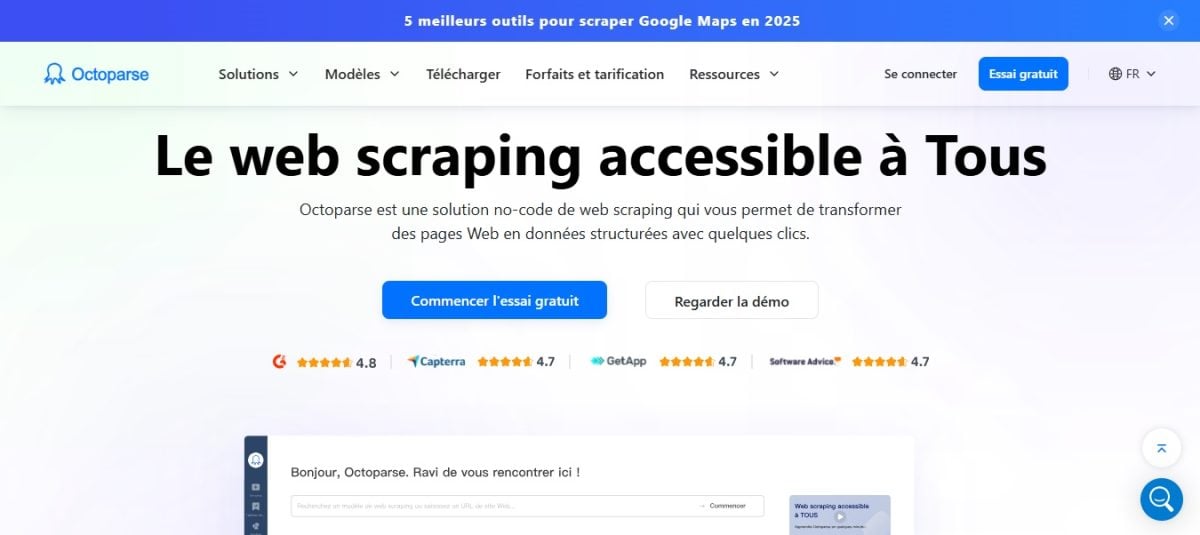
Octoparse permite hacer scraping sin código gracias a una interfaz visual intuitiva. No ofrece plantillas listas para usar para Facebook: solo tienes que pegar la URL de una página o de un perfil, y la herramienta detecta automáticamente los datos y, a continuación, ajustas el flujo de trabajo (desplazamiento, exportación) sin escribir ni una sola línea de código.
Es una buena opción si no tienes sin conocimientos técnicos, siempre y cuando se esté dispuesto a dedicar un tiempo a familiarizarse con el sistema.
Te explicamos todas las funciones en nuestro reseña completa sobre Octoparse.
2. Optar por una solución casera con Python
¿Quieres controlarlo todo? Puedes hacerlo. Crea tu propio scraper de Facebook en Python.
El enfoque clásico combina un navegador automático y una Biblioteca de análisis HTML. Un navegador automatizado abre las páginas tal y como lo haría un usuario real, lo que permite gestionar las interacciones dinámicas de Facebook, como el desplazamiento infinito que carga nuevas publicaciones.
En concreto, el combo Selenium + BeautifulSoup abre las páginas de Facebook como lo haría una persona, espera a que se cargue el contenido y, a continuación, extrae los datos a un archivo JSON Donde CSV.
- Selenium controla el navegador para interactuar con la página: hacer clic, desplazarse, esperar.
- BeautifulSoup a continuación, analiza el código HTML y recupera la información deseada.
Aquí tienes un esbozo de script básico para que te pongas en marcha:
from selenium import webdriver
from bs4 import BeautifulSoup

driver = webdriver.Chrome()
driver.get("https://www.facebook.com/nom-de-la-page")

soup = BeautifulSoup(driver.page_source, "html.parser")
for post in soup.find_all("div", {"role": "article"}):
    print(post.get_text())

driver.quit()
Ojo, la realidad es más dura que el código. Facebook suele exigir una conexión, detecta los bots y limita el número de solicitudes automatizadas. Sin apoderados Si no utilizas rotaciones ni gestionas los CAPTCHAs, tu scraper casero se bloqueará rápidamente. Ahí es donde las herramientas especializadas vuelven a tomar la delantera.
¿Qué puedes rascar en Facebook?
El scraping en Facebook te permite extraer únicamente datos públicos. Estos son los tipos de contenidos disponibles:
- Páginas públicas : nombre de la página, número de le gusta y de suscriptores, texto de los publicaciones, comentarios, comparticiones y reacciones.
- Grupos públicos : Nombre del grupo, descripción, número de miembros y publicaciones visibles sin ser miembro.
- Perfiles públicos : nombre, foto de perfil y, según la configuración de cada usuario, biografía, ciudad y publicaciones públicas.
- Eventos y Reels : título, fecha, lugar y estadísticas de participación visibles públicamente.
Los rastreadores especializados recogen estos elementos y te los entregan en un formato estructurado (CSV Donde JSON), que puedes utilizar directamente para tus análisis. Un resultado típico incluye el identificador de la publicación, el texto, la fecha y el número de le gusta, las reacciones y las comentarios.
La información privada, como la mensajes, la grupos cerrados dónde los perfiles bloqueados quedan fuera del alcance de las herramientas que aquí se presentan, que se limitan a los datos públicos. Intentar acceder a ellos a través de una cuenta conectada infringiría las condiciones generales de uso de Meta y plantearía un verdadero problema en cuanto al respeto de los datos personales.
¿Cómo se puede realizar web scraping en Facebook en 2026?
Con una herramienta específica como Bright Data Donde Apify, un proyecto de scraping de Facebook se desarrolla en cuatro etapas.
1. Elige el scraper adecuado en función de tu público objetivo
Empieza por identificar qué es lo que quieres extraer. Los rastreadores suelen estar especializados por tipo de contenido:
- Facebook Posts Scraper : recoge los publicaciones de una página (texto, fecha, «Me gusta», reacciones, número de comentarios).
- Facebook Pages Scraper : extrae la información de una ficha de empresa (nombre, categoría, dirección, opiniones).
- Facebook Profile Scraper : recoge los datos de un perfil público.
- Facebook Groups Scraper : se centra en las publicaciones y los hilos de debate de un grupo.
Seguro Apify, eliges al actor en la persiana. En Bright Data, seleccionas el Facebook Scraper API que se ajuste a tu objetivo.
2. Introduce la URL de la página o del grupo
La herramienta necesita el’URL exacta de tu objetivo en facebook.com. Cópiala directamente desde la barra de direcciones de tu navegador:
- Para una página: https://www.facebook.com/nomdelapage
- Para un grupo: abre el grupo, haz clic en su nombre y, a continuación, copia el enlace del tipo https://www.facebook.com/groups/id
A continuación, ajusta los opciones : número de publicaciones a recuperar, intervalo de fechas, inclusión de los comentarios y los reacciones. Cuanto más limites el ámbito, más rápida será la extracción.
3. Iniciar la recopilación de datos
Haga clic en Inicio para empezar. La herramienta se encarga por sí sola de los aspectos técnicos: rotación de los apoderados, eludir los sistemas de detección de scraping y gestionar las limitaciones impuestas por Facebook. Es precisamente ahí donde un scraper especializado marca la diferencia frente a una solución propia.
El tiempo de procesamiento depende del volumen: unos segundos para un puñado de publicaciones, varios minutos para un historial extenso.
4. Exportar los datos en el formato adecuado
Una vez finalizada la recopilación, puedes exportarlo todo con un solo clic. Elige el formato según tus necesidades:
- CSV Donde Excel : ideal para ordenar y analizar en una hoja de cálculo.
- JSON : ideal si quieres volver a introducir los datos en tu propio código o en una base de datos.
Un resultado típico contiene el identificador del correo, el texto, la fecha de publicación, el número de le gusta, las reacciones y las comentarios. Obtienes una estructura clara, lista para usar.
¿Por qué desguazar en Facebook?
El scraping te permite acceder a datos públicos que no podrías recopilar manualmente en miles de publicaciones. Estos son los casos de uso más habituales y legítimos:
- Análisis de la competencia: tú te encargas de vigilar los páginas de Facebook de tus competidores para analizar a fondo su estrategia de contenidos. Identificas qué formatos de publicaciones generan mayor interacción, sin tener que pasar horas anotándolo todo a mano.
- Seguimiento y análisis de opiniones: recoger los publicaciones y los comentarios En torno a una marca o un evento, te permite evaluar la opinión general y seguir la evolución de una campaña a lo largo del tiempo.
- Investigación académica y científica: Los investigadores utilizan los datos de Facebook para realizar estudios sociológicos o lingüísticos a gran escala, con el fin de observar la difusión de una información o la evolución de un vocabulario.
- Análisis del rendimiento del contenido: Si gestionas varias páginas, compara tus propias publicaciones para identificar los formatos que funcionan (imagen, Reels, texto) y adaptar tu línea editorial a cifras concretas.
preguntas frecuentes
¿Es legal hacer web scrap en Facebook?
La legalidad del scraping sigue siendo una zona jurídica gris. En principio, recopilar datos públicos no está prohibido por la ley.
El problema radica en otra cosa: las condiciones de uso de Meta prohíben explícitamente la recopilación automatizada de datos sin autorización. Por lo tanto, si realizas un «scraping» mientras estás conectado a tu cuenta de Facebook, estás infringiendo claramente sus condiciones de uso.
En concreto, te arriesgas a dos cosas: la suspensión o el rescisión de tu cuenta, y acciones civiles. Meta Ya ha emprendido acciones legales contra varios servicios de scraping, con resultados dispares.
Ha ganado el caso contra algunos, pero ha perdido frente a Bright Data en 2024: el tribunal dictaminó que sus condiciones generales de uso vigentes en ese momento no cubrían la recogida de datos públicos realizada sin estar conectado, y Meta posteriormente desistió de su demanda.
En Europa, el RGPD se suma a la ecuación. Un dato sigue siendo un datos personales incluso cuando sea de acceso público, siempre que permita identificar a alguien. Por lo tanto, debes reducir al mínimo la recopilación de datos, protegerlos y ceñirte a un uso aceptable, como la vigilancia competitiva anonimizada o la investigación.
¿Cómo puedo scrapear Facebook sin utilizar la API?
Puede crear un scraper de Facebook a medida en Python, sin pasar por una API oficial, pero esto requiere conocimientos técnicos sólidos. Prepárate para encontrarte con varios obstáculos: Facebook suele exigir una conexión, detecta los robots y limita el número de solicitudes automatizadas. Prever apoderados se convierte rápidamente en algo imprescindible para evitar que se atasque.
¿Cuál es la mejor biblioteca? Python ¿Para extraer datos de Facebook?
El dúo Selenium (para simular un navegador) y BeautifulSoup (para analizar el HTML) sigue siendo una de las opciones propias más utilizadas en septiembre de 2026. Selenium carga el contenido dinámico, BeautifulSoup a continuación, extrae datos como los publicaciones, la le gusta dónde los comentarios.
¿Existen herramientas gratuitas de raspado de Facebook?
Bright Data, Octoparse y Apify todos ofrecen pruebas gratuitas para probar sus funciones antes de contratar una suscripción. Estas versiones gratuitas tienen un límite de volumen de datos: son suficientes para una primera prueba, pero para un uso intensivo pronto es necesario optar por una oferta de pago.
¿Cómo puedo extraer datos de los grupos de Facebook?
La mayoría de las herramientas de scraping permiten’extraer datos de grupos públicos. Los grupos privados siguen siendo fuera de su alcance de estas herramientas. Con rastreadores específicos como Facebook Scraper API (Bright Data) o Facebook Groups Scraper (Apify), los pasos a seguir son sencillos:
- Recupera el’URL del grupo desde tu navegador (formato: https://www.facebook.com/groups/…).
- Pega esta URL en la herramienta.
- Configura los campos que desees: publicaciones, fechas, reacciones.
- Inicia la extracción y exporta el resultado a CSV Donde JSON.
Por lo tanto, extraer datos de Facebook en 2026 sigue siendo totalmente posible. Tanto si eres principiante y utilizas una herramienta sin código como Octoparse, o seas un desarrollador con amplia experiencia que prefiere programar su propia solución, hay un enfoque que se adapta a tu perfil y a tus necesidades.
¿Has probado algún otro método? Comparte tu experiencia o deja tus preguntas en los comentarios.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA