Melakukan scraping di Facebook pada tahun 2026 memang bisa dilakukan, tetapi lebih rumit daripada sebelumnya. Facebook secara aktif memblokir program pengikis data, sehingga alat khusus seperti Bright Data Di mana Apify jauh lebih andal daripada solusi buatan sendiri dalam Python.
Berikut ini adalah metode-metode yang benar-benar efektif, hal-hal yang bisa kamu pelajari, dan kerangka hukum yang perlu kamu ketahui sebelum memulainya.

Berbagai metode untuk melakukan scraping di Facebook
itu pengikisan web adalah proses otomatis yang mengekstrak data dari situs web. Di Facebook, kamu memiliki dua pilihan utama: menggunakan sebuah alat yang siap pakai, atau mengembangkan solusi sendiri dengan menggunakan pustaka pemrograman. Pilihannya tergantung pada tingkat keahlian teknismu dan volume data yang ingin kamu ambil.
1. 1. Menggunakan alat bantu pengikisan web
Alat-alat scraping ditujukan bagi mereka yang tidak memiliki tidak memiliki keterampilan pemrograman. Ini adalah solusi siap pakai yang memungkinkan untuk’mengekstrak data hanya dengan beberapa klik. Untuk Facebook, ada tiga solusi yang menonjol: Bright Data, Apify dan Octoparse.
| Alat | Tingkat teknis | Apa yang dia kumpulkan dari Facebook | Harga tiket masuk |
|---|---|---|---|
| Bright Data | Menengah (API) | Halaman, grup, postingan publik, profil | Penetapan harga berdasarkan penggunaan, tersedia uji coba gratis |
| Apify | Pemula hingga menengah | Halaman, postingan, komentar, Reels, marketplace | Penetapan harga berdasarkan penggunaan, tersedia uji coba gratis |
| Octoparse | Pemula (tanpa kode) | Data publik dari halaman dan profil | Tersedia versi gratis dengan fitur terbatas |
Bright Data
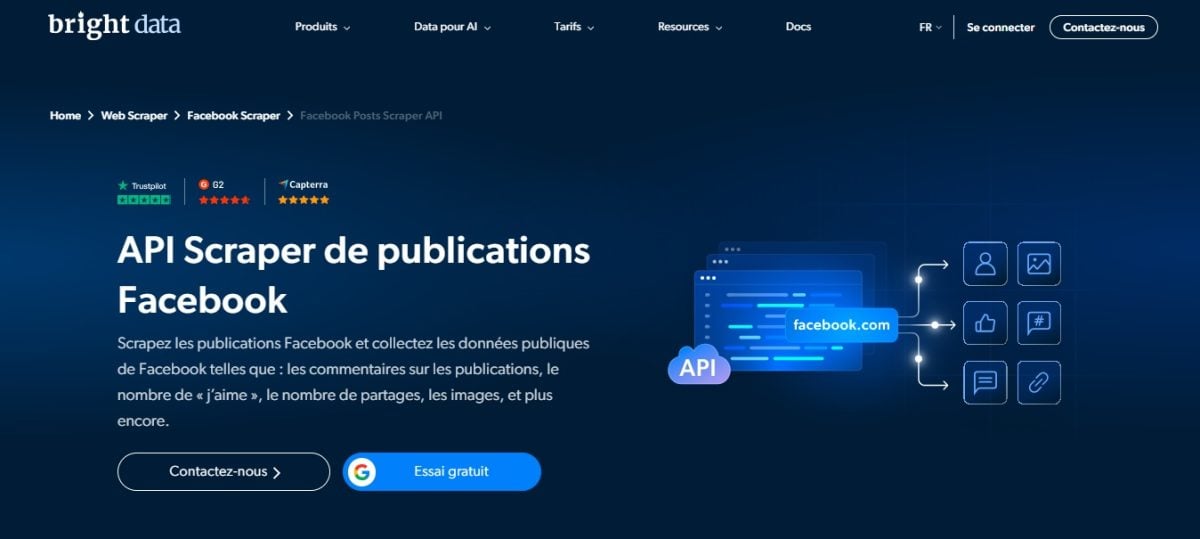
Bright Data menggabungkan jaringan proksi, peramban penggalian, dan API dalam satu platform. Rotasi proxy secara signifikan mengurangi risiko diblokir oleh Facebook, yang merupakan keunggulan yang sangat penting.
Miliknya Facebook Scraper API dirancang untuk itu: kamu memberinya sebuah URL halaman atau grup, dan dia membalasmu dengan data terstruktur dalam format JSON Di mana CSV. Ia sendiri yang menangani cara menghindari sistem perlindungan anti-bot dan menganalisis kode.
Temukan ulasan lengkap tentang Bright Data untuk mempelajari lebih lanjut.
Apify

Apify adalah sebuah platform yang menawarkan solusi yang sudah dibuat sebelumnya yang disebut « Actors ".
Alat andalannya, yaitu Facebook Pages Scraper, mengumpulkan informasi dari halaman publik: nama, kategori, detail kontak, jumlah suka dan pengikut, serta penilaian.
Lainnya Actors menargetkan postingan, yang komentar, yang kelompok atau Facebook Marketplace.
Lihat ulasan lengkap tentang Apify untuk mengetahui lebih lanjut.
Octoparse
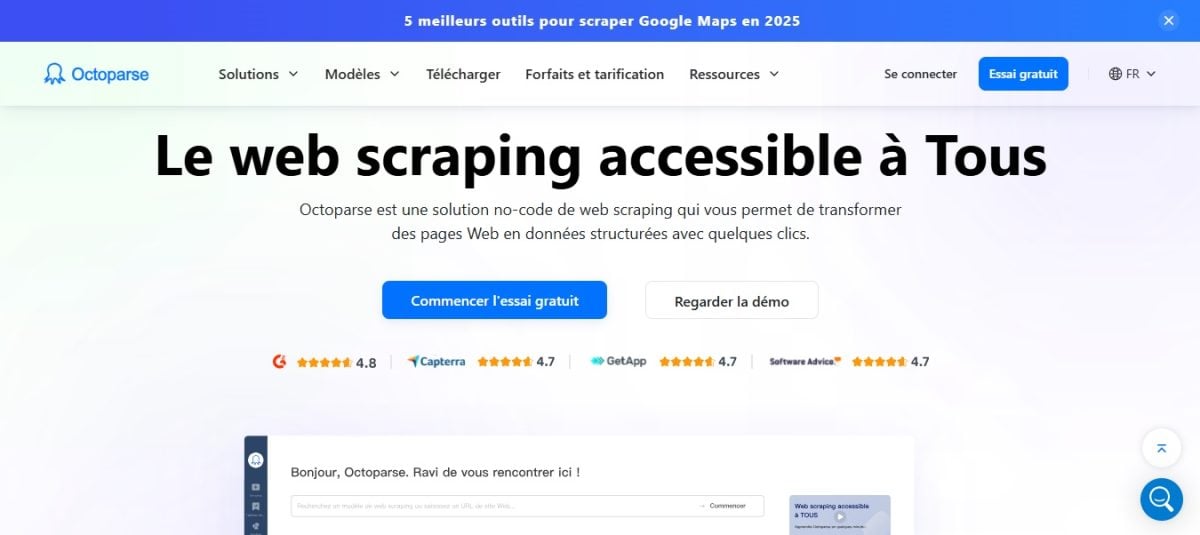
Octoparse memungkinkan untuk melakukan scraping tanpa kode berkat antarmuka visual yang intuitif. Alat ini tidak menyediakan templat siap pakai untuk Facebook: kamu cukup menempelkan URL halaman atau profil, lalu alat ini mendeteksi secara otomatis data, lalu kamu menyesuaikan alur kerja (pengguliran, ekspor) tanpa perlu menulis satu baris kode pun.
Ini adalah pilihan yang bagus jika kamu tidak memiliki tidak memiliki keterampilan teknis, asalkan bersedia meluangkan waktu untuk membiasakan diri.
Kami akan menjelaskan semua fiturnya di ulasan lengkap tentang Octoparse.
2. Memilih solusi buatan sendiri dengan Python
Kamu ingin mengendalikan segalanya? Kamu bisa buat scraper Facebook-mu sendiri di Python.
Pendekatan klasik menggabungkan sebuah peramban otomatis dan Perpustakaan analisis HTML. Sebuah peramban otomatis membuka halaman-halaman seperti yang dilakukan oleh pengguna sungguhan, sehingga memungkinkan pengelolaan interaksi dinamis di Facebook, seperti fitur gulir tak terbatas yang memuat postingan-postingan baru.
Secara konkret, paket Selenium + BeautifulSoup membuka halaman Facebook seperti yang dilakukan manusia, menunggu hingga konten selesai dimuat, lalu mengekstrak data ke dalam sebuah berkas JSON Di mana CSV.
- Selenium mengendalikan peramban untuk berinteraksi dengan halaman: mengklik, menggulir, menunggu.
- BeautifulSoup kemudian menganalisis kode HTML dan mengambil informasi yang diinginkan.
Berikut ini adalah kerangka skrip sederhana untuk memulainya:
from selenium import webdriver
from bs4 import BeautifulSoup

driver = webdriver.Chrome()
driver.get("https://www.facebook.com/nom-de-la-page")

soup = BeautifulSoup(driver.page_source, "html.parser")
for post in soup.find_all("div", {"role": "article"}):
    print(post.get_text())

driver.quit()
Hati-hati, kenyataannya lebih keras daripada kode. Facebook sering kali mensyaratkan sebuah koneksi, mendeteksi bot dan membatasi jumlah permintaan otomatis. Tanpa proxy Tanpa rotasi atau pengelolaan CAPTCHA, scraper buatanmu sendiri akan cepat diblokir. Di sinilah alat-alat khusus kembali unggul.
Apa yang bisa Anda kikis di Facebook?
Scraping di Facebook memungkinkanmu untuk mengambil hanya data publik. Berikut ini adalah jenis-jenis konten yang dapat diakses:
- Halaman publik : nama halaman, jumlah suka dan pelanggan, teks dari posting, komentar, bagikan, dan tanggapan.
- Grup publik : nama grup, deskripsi, jumlah anggota, dan postingan yang dapat dilihat tanpa harus menjadi anggota.
- Profil publik : nama, foto profil, dan—tergantung pengaturan pengguna—biografi, kota, serta postingan publik.
- Acara dan Reels : judul, tanggal, lokasi, dan statistik keterlibatan yang dapat dilihat oleh publik.
Scraper khusus mengumpulkan elemen-elemen tersebut dan menyajikannya kepadamu dalam format terstruktur (CSV Di mana JSON), yang langsung dapat digunakan untuk analisismu. Hasil yang umum mencakup ID postingan, teks, tanggal, jumlah suka, tanggapan dan komentar.
Informasi pribadi seperti pesan, yang grup tertutup atau profil yang terkunci tetap berada di luar jangkauan alat-alat yang disajikan di sini, yang hanya terbatas pada data publik. Mencoba mengaksesnya melalui akun yang terhubung akan melanggar Ketentuan Penggunaan dari Meta dan akan menimbulkan masalah serius terkait perlindungan data pribadi.
Bagaimana cara melakukan web scraping di Facebook pada tahun 2026?
Dengan alat khusus seperti Bright Data Di mana Apify, sebuah proyek pengambilan data dari Facebook dilakukan dalam empat tahap.
1. Pilih scraper yang tepat sesuai dengan targetmu
Mulailah dengan mengidentifikasi apa yang ingin kamu ekstrak. Scraper biasanya dirancang khusus untuk jenis konten tertentu:
- Facebook Posts Scraper : mengambil publikasi satu halaman (teks, tanggal, suka, reaksi, jumlah komentar).
- Facebook Pages Scraper : mengambil informasi dari halaman bisnis (nama, kategori, alamat, ulasan).
- Facebook Profile Scraper : mengumpulkan data dari sebuah Profil publik.
- Facebook Groups Scraper : menargetkan postingan dan diskusi dalam sebuah grup.
Pada Apify, kamu memilih aktor di menu drop-down. Di Bright Data, pilih Facebook Scraper API yang sesuai dengan targetmu.
2. Masukkan URL halaman atau grup
Alat ini memerlukan’URL yang tepat targetmu di facebook.com. Salin langsung dari bilah alamat browser-mu:
- Untuk satu halaman: https://www.facebook.com/nomdelapage
- Untuk sebuah grup: buka grup tersebut, klik namanya, lalu salin tautan berformat https://www.facebook.com/groups/id
Selanjutnya, sesuaikan pilihan : jumlah posting yang akan diambil, rentang tanggal, penyertakan komentar dan reaksi. Semakin sempit cakupannya, semakin cepat proses ekstraksi tersebut.
3. Memulai pengumpulan data
Klik pada Mulai untuk memulai. Alat ini secara otomatis menangani bagian-bagian teknisnya: rotasi proxy, menghindari deteksi anti-scraping, dan mengatasi batasan yang diberlakukan oleh Facebook. Di sinilah tepatnya scraper khusus menunjukkan keunggulannya dibandingkan dengan solusi buatan sendiri.
Waktu pemrosesan tergantung pada volumenya: beberapa detik untuk segenggam publikasi, beberapa menit untuk riwayat yang panjang.
4. Mengekspor data dalam format yang tepat
Setelah proses pengumpulan selesai, kamu bisa mengekspor semuanya hanya dengan satu klik. Pilih format yang sesuai dengan kebutuhanmu:
- CSV Di mana Excel : sangat cocok untuk menyortir dan menganalisis data dalam lembar kerja.
- JSON : sangat cocok jika kamu ingin memasukkan kembali data tersebut ke dalam kode kamu sendiri atau ke dalam basis data.
Hasil yang umum mencakup pengenal dari pos, teks, tanggal terbit, jumlah suka, tanggapan dan komentar. Kamu akan mendapatkan struktur yang rapi dan langsung dapat digunakan.
Mengapa memo di Facebook?
Scraping memungkinkan kamu mengakses data publik yang tidak mungkin kamu kumpulkan secara manual dari ribuan postingan. Berikut adalah contoh penggunaan yang paling umum dan sah:
- Analisis persaingan: kamu mengawasi halaman Facebook dari pesaingmu untuk menganalisis strategi konten mereka. Kamu mengidentifikasi format-format apa saja yang posting menghasilkan tingkat keterlibatan tertinggi, tanpa harus menghabiskan berjam-jam untuk mencatat semuanya secara manual.
- Pemantauan dan analisis sentimen: mengumpulkan posting dan komentar Pembahasan seputar sebuah merek atau acara memungkinkan Anda untuk mengukur opini umum dan memantau perkembangan suatu kampanye dari waktu ke waktu.
- Penelitian akademis dan ilmiah: Para peneliti memanfaatkan data Facebook untuk penelitian sosiologis atau linguistik berskala besar, guna mengamati penyebaran suatu informasi atau perkembangan kosakata.
- Analisis kinerja konten: jika kamu mengelola beberapa halaman, bandingkan halaman-halamanmu sendiri posting untuk mengidentifikasi format yang efektif (gambar, Reels, teks) dan sesuaikan garis editorialmu berdasarkan angka-angka konkret.
FAQ
Apakah legal untuk web scrap di Facebook?
Keabsahan praktik scraping tetap menjadi wilayah abu-abu hukum. Pada dasarnya, mengumpulkan data publik tidak dilarang oleh undang-undang.
Masalahnya justru berasal dari tempat lain: ketentuan penggunaan Meta secara eksplisit melarang pengumpulan data secara otomatis tanpa izin. Jadi, jika kamu melakukan scraping saat sedang masuk ke akun Facebook-mu, kamu jelas melanggar Ketentuan Layanan (KL) Facebook.
Secara konkret, ada dua risiko yang mungkin kamu hadapi: penangguhan atau pengakhiran dari akunmu, serta tuntutan perdata. Meta telah menggugat beberapa layanan scraping ke pengadilan, dengan hasil yang bervariasi.
Dia berhasil memenangkan gugatan terhadap beberapa pihak, tetapi kalah dalam gugatan terhadap Bright Data pada tahun 2024: pengadilan memutuskan bahwa Ketentuan Layanan (KL) yang berlaku saat itu tidak mencakup pengumpulan data publik yang dilakukan tanpa koneksi internet, dan Meta kemudian menghentikan gugatannya.
Di Eropa, sistem RGPD menjadi faktor tambahan dalam persamaan tersebut. Sebuah data tetap merupakan data pribadi bahkan ketika data tersebut dapat diakses publik, asalkan data tersebut dapat mengidentifikasi seseorang. Oleh karena itu, Anda harus meminimalkan pengumpulan data, mengamankan data, dan tetap berada dalam batas penggunaan yang dapat diterima, seperti pemantauan persaingan yang dianonimkan atau penelitian.
Bagaimana cara mengikis Facebook tanpa menggunakan API?
Anda bisa membuat scraper Facebook yang disesuaikan dengan kebutuhan dalam Python, tanpa melalui API resmi, tetapi hal ini membutuhkan keterampilan teknis yang mumpuni. Bersiaplah menghadapi berbagai kendala: Facebook sering kali mensyaratkan sebuah koneksi, mendeteksi bot dan membatasi jumlah permintaan otomatis. Siapkan proxy dengan cepat menjadi sangat penting untuk mencegah terjadinya kemacetan.
Perpustakaan mana yang terbaik? Python untuk mengumpulkan data dari Facebook?
Duo Selenium (untuk mensimulasikan peramban) dan BeautifulSoup (untuk menganalisis HTML) tetap menjadi salah satu opsi buatan sendiri yang paling banyak digunakan pada bulan September 2026. Selenium memuat konten dinamis, BeautifulSoup kemudian mengekstrak data seperti postingyang suka atau komentar.
Apakah ada alat pengikis Facebook gratis?
Bright Data, Octoparse dan Apify semuanya menawarkan uji coba gratis untuk mencoba fitur-fiturnya sebelum berlangganan. Versi gratis ini memiliki batasan kuota data: kuota tersebut cukup untuk uji coba awal, tetapi untuk penggunaan yang lebih intensif, Anda akan segera membutuhkan paket berbayar.
Bagaimana cara mengekstrak data dari grup Facebook?
Sebagian besar alat scraping memungkinkan pengguna untuk’Mengekstrak data dari grup publik. Grup-grup pribadi tetap ada di luar jangkauan alat-alat tersebut. Dengan scraper khusus seperti Facebook Scraper API (Bright Data) atau Facebook Groups Scraper (Apify), langkah-langkahnya sederhana:
- Ambil’URL grup dari perambanmu (format: https://www.facebook.com/groups/…).
- Tempelkan URL ini ke dalam alat tersebut.
- Atur kolom yang diinginkan: posting, tanggal, tanggapan.
- Jalankan proses ekstraksi dan ekspor hasilnya ke CSV Di mana JSON.
Jadi, melakukan scraping Facebook pada tahun 2026 masih sangat mungkin dilakukan. Baik kamu seorang pemula yang menggunakan alat tanpa kode seperti Octoparse, baik kamu seorang pemula maupun pengembang berpengalaman yang lebih suka membuat kode sendiri, ada pendekatan yang sesuai dengan profil dan kebutuhanmu.
Sudahkah kamu mencoba metode lain? Bagikan pengalamanmu atau ajukan pertanyaanmu di kolom komentar.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA