Effettuare lo scraping su Facebook nel 2026 è fattibile, ma più complicato rispetto al passato. Facebook blocca attivamente gli scraper, il che rende gli strumenti dedicati come Bright Data Dove Apify molto più affidabili di una soluzione fai-da-te in Python.
Ecco i metodi che funzionano davvero, cosa puoi ricavarne e il quadro giuridico Cose da sapere prima di iniziare.

I diversi metodi di scraping su Facebook
il scraping del web è un processo automatizzato che estrae dei dati da siti web. Su Facebook hai due opzioni principali: utilizzare un strumento pronto all’uso, oppure sviluppare una soluzione personalizzata utilizzando librerie di programmazione. La scelta dipende dal tuo livello tecnico e dal volume di dati che desideri recuperare.
1. Utilizzo di strumenti di web scraping
Gli strumenti di scraping sono pensati per chi non ha nessuna competenza di programmazione. Si tratta di soluzioni chiavi in mano che consentono di’estrarre dati con pochi clic. Per Facebook, spiccano tre soluzioni: Bright Data, Apify e Octoparse.
| Attrezzo | Livello tecnico | Quello che raccoglie da Facebook | Prezzo del biglietto d'ingresso |
|---|---|---|---|
| Bright Data | Intermedio (API) | Pagine, gruppi, post pubblici, profili | Tariffazione a consumo, prova gratuita disponibile |
| Apify | Da principiante a livello intermedio | Pagine, post, commenti, Reels, Marketplace | Tariffazione a consumo, prova gratuita disponibile |
| Octoparse | Principiante (senza codice) | Dati pubblici relativi a pagine e profili | È disponibile una versione gratuita con funzionalità limitate |
Bright Data
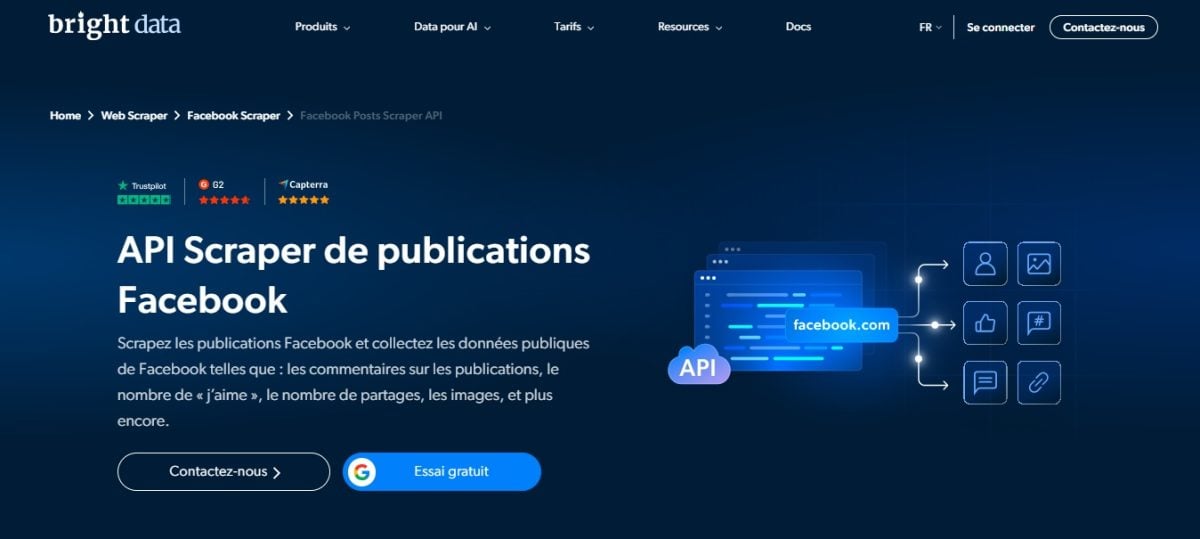
Bright Data combina proxy di rete, scraping di browser e API in un'unica piattaforma. La rotazione di deleghe riduce notevolmente il rischio di essere bloccati da Facebook, il che rappresenta un vantaggio decisivo.
Suo Facebook Scraper API è pensato proprio per questo: gli dai una URL di una pagina o di un gruppo, e ti restituisce dei dati strutturati in formato JSON Dove CSV. Si occupa autonomamente di aggirare le protezioni anti-bot e di analizzare il codice.
Scopri il nostro recensione completa su Bright Data per approfondire l'argomento.
Apify

Apify è una piattaforma che offre soluzioni precostituite denominate « Actors ".
Il suo prodotto di punta, il Facebook Pages Scraper, raccoglie le informazioni dalle pagine pubbliche: nome, categoria, recapiti, numero di "Mi piace" e di follower, valutazione.
altri Actors si rivolgono ai post, loro commenti, loro gruppi dove il Facebook Marketplace.
Dai un'occhiata al nostro recensione completa su Apify per saperne di più.
Octoparse
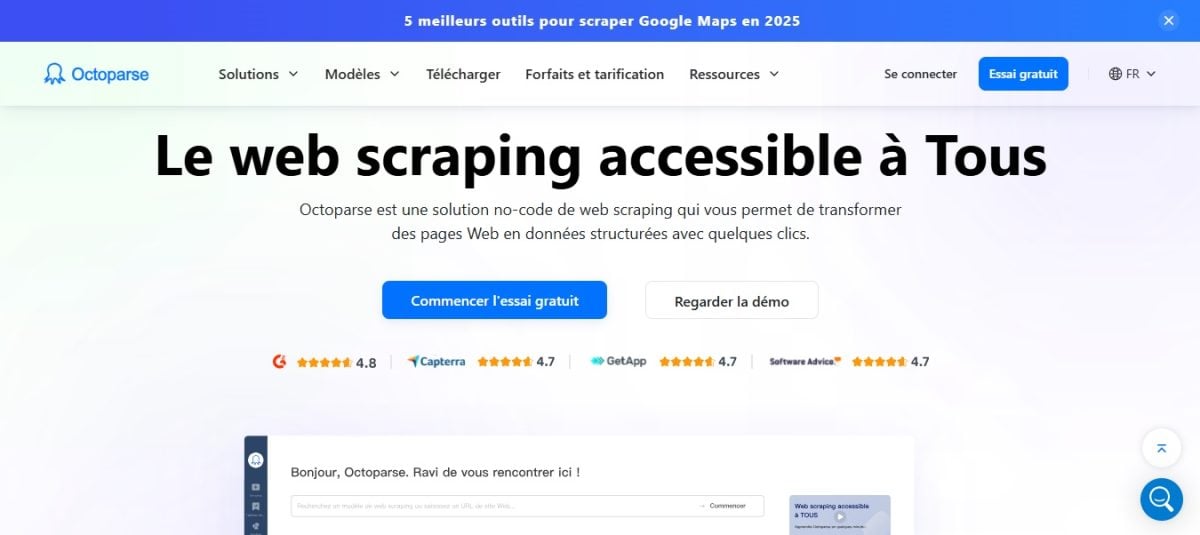
Octoparse permette di fare scraping senza codice grazie a un’interfaccia visiva intuitiva. Non offre modelli già pronti per Facebook: basta incollare l’URL di una pagina o di un profilo e lo strumento rileva automaticamente i dati, poi puoi personalizzare il flusso di lavoro (scorrimento, esportazione) senza scrivere una sola riga di codice.
È una buona opzione se non hai nessuna competenza tecnica, a condizione di accettare un periodo di adattamento.
Ti spieghiamo tutte le funzionalità nel nostro recensione completa su Octoparse.
2. Scegliere una soluzione fai da te con Python
Vuoi avere tutto sotto controllo? Puoi farlo crea il tuo scraper personalizzato per Facebook in Python.
L'approccio classico combina un navigatore automatizzato e un Libreria di analisi HTML. Un browser automatizzato apre le pagine proprio come farebbe un utente reale, consentendo così di gestire le interazioni dinamiche di Facebook, come lo scorrimento infinito che carica nuovi post.
In pratica, il combo Selenium + BeautifulSoup apre le pagine Facebook come farebbe un essere umano, attende il caricamento dei contenuti, quindi esporta i dati in un file JSON Dove CSV.
- Selenium comanda il browser per interagire con la pagina: cliccare, scorrere, attendere.
- BeautifulSoup analizza poi il codice HTML e recupera le informazioni desiderate.
Ecco una struttura di script minima per iniziare:
from selenium import webdriver
from bs4 import BeautifulSoup

driver = webdriver.Chrome()
driver.get("https://www.facebook.com/nom-de-la-page")

soup = BeautifulSoup(driver.page_source, "html.parser")
for post in soup.find_all("div", {"role": "article"}):
    print(post.get_text())

driver.quit()
Attenzione: la realtà è più dura del codice. Facebook richiede spesso una connessione, rileva i bot e limita il numero di richieste automatizzate. Senza deleghe Senza rotazioni né gestione dei CAPTCHA, il tuo scraper fatto in casa verrà presto bloccato. È qui che gli strumenti dedicati tornano in vantaggio.
Che cosa si può scrappare su Facebook?
Lo scraping su Facebook ti permette di recuperare solo i dati pubblici. Ecco i tipi di contenuti disponibili:
- Pagine pubbliche : nome della pagina, numero di piace e degli abbonati, testo dei post, Commenti, condivisioni e reazioni.
- Gruppi pubblici : nome del gruppo, descrizione, numero di membri e pubblicazioni visibili anche senza essere iscritti.
- Profili pubblici : nome, foto del profilo e, a seconda delle impostazioni dell'utente, biografia, città e post pubblici.
- Eventi e Reels : titolo, data, luogo e statistiche di partecipazione visibili pubblicamente.
Gli scraper dedicati recuperano questi elementi e te li forniscono in un formato strutturato (CSV Dove JSON), direttamente utilizzabili per le tue analisi. Un risultato tipico include l'ID del post, il testo, la data, il numero di piace, le reazioni e le Commenti.
Le informazioni private come le messaggi, loro gruppi chiusi dove il profili bloccati rimangono fuori dalla portata degli strumenti qui presentati, che si limitano ai dati pubblici. Cercare di accedervi tramite un account connesso violerebbe i Termini di utilizzo di Meta e porrebbe un vero problema in materia di protezione dei dati personali.
Come si fa il web scraping su Facebook nel 2026?
Con uno strumento dedicato come Bright Data Dove Apify, un progetto di scraping su Facebook si articola in quattro fasi.
1. Scegliere lo scraper giusto in base al proprio target
Inizia individuando ciò che vuoi estrarre. Gli scraper sono spesso specializzati per tipo di contenuto:
- Facebook Posts Scraper : recupera i pubblicazioni di una pagina (testo, data, “Mi piace”, reazioni, numero di commenti).
- Facebook Pages Scraper : estrae le informazioni da una pagina aziendale (nome, categoria, indirizzo, recensioni).
- Facebook Profile Scraper : raccoglie i dati da un profilo pubblico.
- Facebook Groups Scraper : si concentra sui post e sulle discussioni di un gruppo.
SU Apify, scegli l'attore nella tendina. Su Bright Data, seleziona il Facebook Scraper API che corrisponda al tuo obiettivo.
2. Inserire l'URL della pagina o del gruppo
Lo strumento richiede l’URL esatto del tuo bersaglio su facebook.com. Copiala direttamente dalla barra degli indirizzi del tuo browser:
- Per una pagina: https://www.facebook.com/nomdelapage
- Per un gruppo: apri il gruppo, clicca sul suo nome, quindi copia il link del tipo https://www.facebook.com/groups/id
Quindi, regola i opzioni : numero di post da recuperare, intervallo di date, inclusione di Commenti e reazioni. Più si restringe l’ambito, più veloce è l’estrazione.
3. Avviare la raccolta dei dati
Fare clic su Inizio per iniziare. Lo strumento gestisce autonomamente gli aspetti tecnici: rotazione dei deleghe, aggiramento dei sistemi di rilevamento anti-scraping e gestione delle limitazioni imposte da Facebook. È proprio qui che uno scraper dedicato fa la differenza rispetto a una soluzione fatta in casa.
Il tempo di elaborazione dipende dal volume: pochi secondi per una manciata di pubblicazioni, diversi minuti per una cronologia estesa.
4. Esportare i dati nel formato corretto
Una volta completata la raccolta, puoi esportare tutto con un solo clic. Scegli il formato in base alle tue esigenze:
- CSV Dove Excel : ideale per ordinare e analizzare i dati in un foglio di calcolo.
- JSON : perfetto se vuoi reinserire i dati nel tuo codice o in un database.
Un risultato tipico contiene l'identificativo del inviare, il testo, la data di pubblicazione, il numero di piace, le reazioni e le Commenti. Si ottiene una struttura pulita, immediatamente utilizzabile.
Perché rottamare su Facebook?
Lo scraping ti permette di accedere a dati pubblici che non potresti raccogliere manualmente da migliaia di post. Ecco i casi d’uso più comuni e legittimi:
- Analisi della concorrenza: tieni d'occhio i pagine Facebook dei tuoi concorrenti per analizzare a fondo la loro strategia di contenuti. Individua quali formati di post generano il maggior coinvolgimento, senza dover passare ore a trascrivere tutto manualmente.
- Monitoraggio e analisi del sentiment: raccogliere i post e il Commenti Il monitoraggio dell’opinione pubblica su un marchio o un evento ti permette di valutare il sentiment generale e di seguire l’andamento di una campagna nel tempo.
- Ricerca accademica e scientifica: I ricercatori utilizzano i dati di Facebook per studi sociologici o linguistici su larga scala, al fine di osservare la diffusione di un’informazione o l’evoluzione di un vocabolario.
- Analisi delle prestazioni dei contenuti: Se gestisci più pagine, confronta le tue post per individuare i formati che funzionano (immagine, Reels, testo) e adattare la tua linea editoriale sulla base di dati concreti.
Domande frequenti
È legale fare web scraping su Facebook?
La legalità dello scraping rimane una area grigia legale. In linea di principio, raccogliere dei dati pubblici non è vietato dalla legge.
Il problema sta altrove: le condizioni d’uso di Meta vietano esplicitamente la raccolta automatizzata di dati senza autorizzazione. Se effettui lo scraping mentre sei connesso al tuo account Facebook, stai quindi chiaramente violando i suoi Termini di servizio.
In pratica, corri due rischi: il sospensione o il risoluzione del tuo conto e di azioni civili. Meta ha già citato in giudizio diversi servizi di scraping, con risultati variabili.
Ha avuto la meglio su alcuni, ma ha perso contro Bright Data nel 2024: il tribunale ha stabilito che le sue condizioni generali d'uso allora in vigore non coprivano la raccolta di dati pubblici effettuata senza connessione a Internet, e Meta ha poi rinunciato alla causa.
In Europa, il RGPD si aggiunge all'equazione. Un dato rimane un dato personale anche quando è accessibile al pubblico, purché consenta di identificare una persona. È quindi necessario ridurre al minimo la raccolta dei dati, garantirne la sicurezza e attenersi a un uso accettabile, come l'analisi della concorrenza in forma anonima o la ricerca.
Come posso effettuare lo scrape di Facebook senza utilizzare l'API?
È possibile creare uno scraper personalizzato per Facebook in Python, senza ricorrere a un’API ufficiale, ma ciò richiede competenze tecniche concrete. Preparati ad affrontare diversi ostacoli: Facebook spesso richiede una connessione, rileva i bot e limita il numero di richieste automatizzate. Prevedere deleghe diventa ben presto indispensabile per evitare il blocco.
Qual è la migliore biblioteca? Python per fare scraping su Facebook?
Il duo Selenium (per simulare un browser) e BeautifulSoup (per analizzare l'HTML) rimane una delle opzioni interne più utilizzate nel settembre 2026. Selenium carica il contenuto dinamico, BeautifulSoup estrae quindi i dati quali i post, loro piace dove il Commenti.
Esistono strumenti gratuiti di scraper per Facebook?
Bright Data, Octoparse e Apify offrono tutti dei prove gratuite per provarne le funzionalità prima di sottoscrivere un abbonamento. Queste versioni gratuite presentano limiti in termini di volume di dati: sono sufficienti per una prima prova, ma un utilizzo intensivo richiede ben presto un’offerta a pagamento.
Come posso estrarre i dati dai gruppi di Facebook?
La maggior parte degli strumenti di scraping consente di’estrarre i dati dai gruppi pubblici. I gruppi privati rimangono fuori portata di questi strumenti. Con scraper dedicati come Facebook Scraper API (Bright Data) oppure Facebook Groups Scraper (Apify), la procedura da seguire è semplice:
- Recupera l’URL del gruppo dal tuo browser (formato: https://www.facebook.com/groups/…).
- Incolla questo URL nello strumento.
- Configura i campi desiderati: pubblicazioni, date, commenti.
- Avvia l'estrazione ed esporta il risultato in CSV Dove JSON.
Il scraping su Facebook nel 2026 rimane quindi del tutto possibile. Che tu sia un principiante con uno strumento no-code come Octoparse, o che tu sia uno sviluppatore esperto che preferisce programmare la propria soluzione, esiste un approccio adatto al tuo profilo e alle tue esigenze.
Hai provato un altro metodo? Condividi la tua esperienza o fai le tue domande nei commenti.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA