2026年にFacebookからデータをスクレイピングすることは可能ですが、以前よりも複雑になっています。. Facebookはスクレイパーを積極的にブロックしている, そのため、次のような専用ツールが Bright Data どこ Apify 自作のソリューションよりもはるかに信頼性が高い Python.
実際に効果のある方法、そこから得られるもの、そして 法的枠組み 始める前に知っておくべきこと。.

フェイスブックにおけるスクレイピングのさまざまな方法
the ウェブスクレイピング は、データを抽出する自動化されたプロセスであり、 データ ウェブサイトから。Facebookでは、主に2つの選択肢があります:1つは すぐに使えるツール, 、あるいはプログラミングライブラリを使って独自のソリューションを開発することもできます。どちらを選ぶかは、あなたの技術レベルや取得したいデータ量によって異なります。.
1.ウェブスクレイピングツールの使用
スクレイピングツールは、次のような方々を対象としています。 プログラミングスキルなし. これらは、以下のことが可能になるターンキーソリューションであり、’数回のクリックでデータを抽出する. Facebookに関しては、3つの解決策が特に注目されています: Bright Data, Apify と Octoparse.
| 道具 | 技術レベル | 彼がFacebookからスクレイピングしているもの | 入場料 |
|---|---|---|---|
| Bright Data | 中級(API) | ページ、グループ、公開投稿、プロフィール | 従量課金制、無料トライアルあり |
| Apify | 初心者~中級者 | ページ、投稿、コメント、リール、マーケットプレイス | 従量課金制、無料トライアルあり |
| Octoparse | 初心者(コードなし) | ページおよびプロフィールの公開データ | 機能限定の無料版が利用可能です |
Bright Data
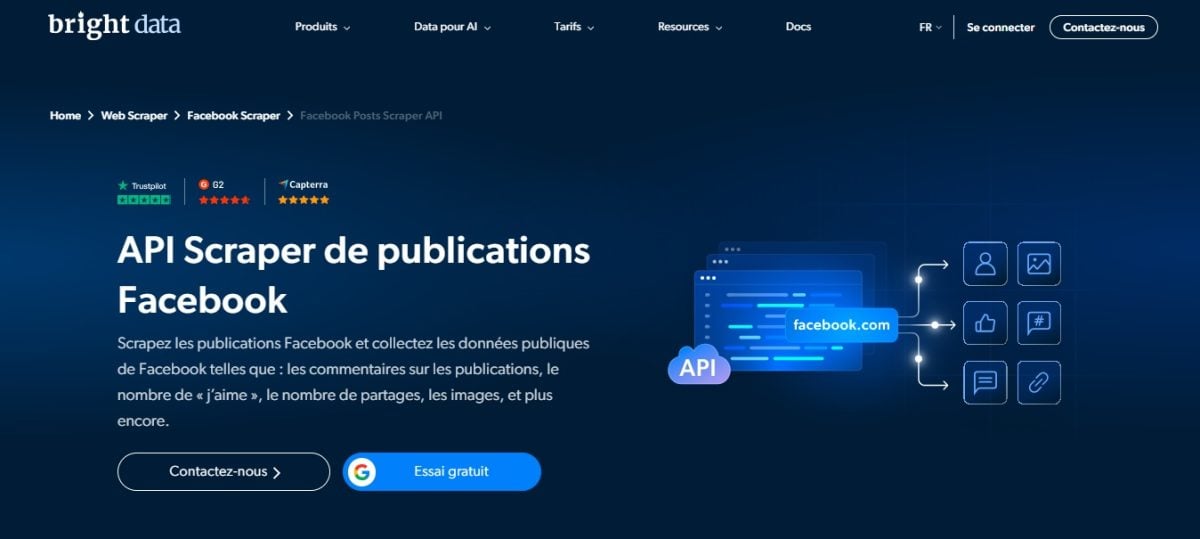
Bright Data 組み合わせる プロキシ・ネットワーク、スクレイピング・ブラウザ、API 単一のプラットフォームに統合。のローテーションは 代理人 Facebookによるブロックされるリスクを大幅に低減でき、これは決定的な利点である。.
彼の Facebook Scraper API そのために設計されているんだ:君がそれに URL ページやグループの、そしてそれはあなたに 構造化データ 形式は JSON どこ CSV. ボット対策の回避やコードの解析は、すべて単独で処理している。.
ぜひ当社の 【完全レビュー】 Bright Data さらに詳しく知りたい方は。.
Apify

Apify は、以下のサービスを提供するプラットフォームです。 構築済みソリューション 「« Actors "。
同社の主力製品である、 Facebook Pages Scraper, 、公開ページの情報(名称、カテゴリ、連絡先、いいね!数、フォロワー数、評価)を収集します。.
その他 Actors をターゲットにしている 投稿、, 彼ら コメント、, 彼ら グループ どこ Facebook Marketplace.
当社の 【完全レビュー】 Apify もっと知るために。
Octoparse
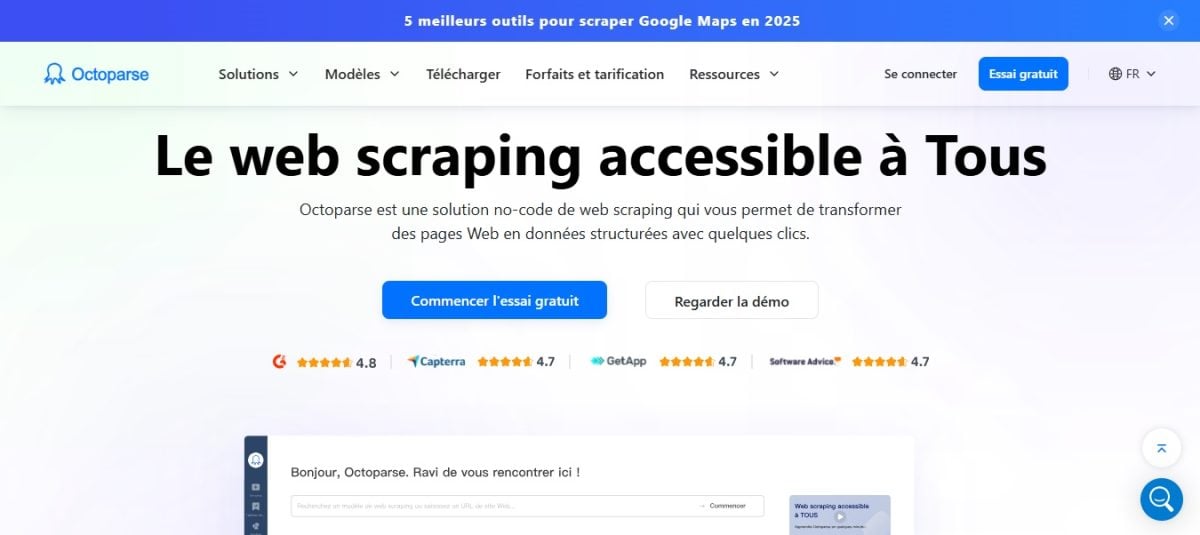
Octoparse ~を行うことができます コード不要のスクレイピング 直感的なビジュアルインターフェースのおかげで。Facebook用の既成テンプレートは用意されていません。ページやプロフィールのURLを貼り付けると、このツールは 自動的に検出する データを入力し、コードを1行も書かずにワークフロー(スクロール、エクスポート)を調整します。.
もしあなたが~を持っていないなら、これは良い選択肢です 技術力がない, 、ただし、慣れるまでの時間を要することを承知の上であれば。.
当サイトの 【完全レビュー】 Octoparse.
2. 以下の方法を用いた自作ソリューションを選ぶ Python
すべてをコントロールしたい? できるよ 自分だけのFacebookスクレイパーを作成する の Python.
従来のアプローチでは、 自動ナビゲーター と HTML解析ライブラリ。 自動化されたブラウザは、実際のユーザーと同じようにページを開くため、新しい投稿を読み込む無限スクロールなど、Facebookの動的な操作を処理することができます。.
具体的には、 コンボ Selenium + BeautifulSoup 人間と同じようにFacebookのページを開き、コンテンツの読み込みを待ってから、データをファイルに抽出する JSON どこ CSV.
- Selenium ブラウザを操作してページとやり取りします:クリック、スクロール、待機など。.
- BeautifulSoup 続いて、以下の点を分析する HTMLコード そして、必要な情報を取得します。.
まずは、始めるための最低限のスクリプトの骨組みを以下に示します:
from selenium import webdriver
from bs4 import BeautifulSoup

driver = webdriver.Chrome()
driver.get("https://www.facebook.com/nom-de-la-page")

soup = BeautifulSoup(driver.page_source, "html.parser")
for post in soup.find_all("div", {"role": "article"}):
    print(post.get_text())

driver.quit()
ご注意ください。現実はコードよりも厳しいものです。Facebookではしばしば、 繋がり, 、ボットを検知し、自動リクエストの数を制限します。なし 代理人 ローテーション機能やCAPTCHA対策がなければ、自作のスクレイパーはすぐにブロックされてしまいます。そこが、専用ツールの真価が発揮される場面です。.
フェイスブックで何ができるのか?
Facebookでのスクレイピングでは、以下の情報のみを取得することができます。 公開データ. 利用可能なコンテンツの種類は以下の通りです:
- 公開ページ: ページ名、件数 好き および購読者数、以下の本文 投稿, コメント, 、シェアやリアクション。.
- 公共団体: グループ名、概要、メンバー数、および公開されている投稿は、メンバー登録しなくても閲覧可能です。.
- 公開プロフィール : 名前、プロフィール写真、および本人の設定に応じて、自己紹介、居住地、公開投稿。.
- イベントと Reels : タイトル、日付、場所、および参加統計が一般に公開されている。.
専用のスクレイパーがこれらの要素を抽出・収集し、構造化された形式で提供します(CSV どこ JSON)、分析にそのまま活用できるデータです。典型的な結果には、投稿のID、本文、日付、件数などが含まれます。 好き, 、反応や コメント.
以下のような個人情報など のメッセージがある、 彼ら 非公開グループ どこ ロックされたプロフィール ここでは紹介するツールでは扱えないものであり、これらのツールは公開データのみに限定されています。ログイン済みアカウントを通じてこれらにアクセスしようとすると、の利用規約に違反することになります。 Meta そして、個人情報の保護という点で深刻な問題を引き起こすことになるだろう。.
2026年にFacebookでウェブスクレイピングを行うにはどうすればよいでしょうか?
次のような専用ツールを使って Bright Data どこ Apify, 、Facebookのスクレイピングプロジェクトは4つの段階を経て行われます。.
1. ターゲットに合わせて適切なスクレイパーを選ぶ
まず、抽出したい内容を特定することから始めましょう。スクレイパーは、多くの場合、コンテンツの種類ごとに特化しています:
- Facebook Posts Scraper : を取得する 出版物 1ページ分(本文、日付、いいね!、リアクション、コメント数)。.
- Facebook Pages Scraper : ビジネスページの情報(名称、カテゴリ、住所、口コミ)を抽出します。.
- Facebook Profile Scraper : あるものからデータを収集する プロフィール を公開した。
- Facebook Groups Scraper : グループ内の投稿やスレッドを対象とします。.
の上 Apify, 、ストアから俳優を選びます。 Bright Data, を選択して Facebook Scraper API あなたのターゲットに合ったもの。.
2. ページまたはグループのURLを入力してください
このツールには、’正確なURL ターゲットの facebook.com. ブラウザのアドレスバーから直接コピーしてください:
- 1ページの場合: https://www.facebook.com/nomdelapage
- グループの場合:グループを開き、その名前をクリックしてから、次のようなリンクをコピーします。 https://www.facebook.com/groups/id
次に、それらを調整して オプション : 数 投稿 取得対象、日付範囲、以下の条件を含む コメント と 反応. 範囲を狭めれば狭めるほど、抽出は速くなります。.
3. データ収集を開始する
をクリックする。 スタート まずはここから始めましょう。このツールは、技術的な部分――例えば回転などの――を自動的に処理してくれます。 代理人, 、スクレイピング防止機能の回避や、Facebookによる制限への対応。まさにこの点において、専用のスクレイパーは自社開発のソリューションとは一線を画すのです。.
処理時間は量によって異なります。一握り程度であれば数秒で 出版物, 、長い履歴の場合は数分かかります。.
4. データを適切な形式でエクスポートする
データの収集が完了したら、ワンクリックですべてをエクスポートできます。用途に合わせて形式を選択してください:
- CSV どこ エクセル : スプレッドシートでの分類や分析に最適です。.
- JSON : データを自分のコードやデータベースに再読み込みしたい場合に最適です。.
典型的な結果には、 役職, 、本文、公開日、件数 好き, 、反応や コメント. すぐに活用できる、すっきりとした構造が得られます。.
なぜフェイスブックでスクラップをするのか?
スクレイピングを使えば、 公開データ 何千もの投稿から手作業では収集できないようなデータです。以下に、最も一般的かつ正当な活用例を挙げます:
- 競合分析: 君はそれらを監視している Facebookページ 競合他社のコンテンツ戦略を徹底的に分析する。どのような形式の 投稿 手作業で何時間もかけてすべてを記録することなく、最も高いエンゲージメントを生み出します。.
- モニタリングとセンチメント分析: を収集する 投稿 そしてその コメント ブランドやイベントを軸に分析を行うことで、世論を把握し、キャンペーンの推移を長期的に追跡することができます。.
- 学術・科学研究: 研究者たちは、情報の拡散や語彙の変遷を観察するために、Facebookのデータを活用して大規模な社会学的・言語学的研究を行っている。.
- コンテンツのパフォーマンス分析: 複数のページを管理している場合は、自分のページ同士を比較して 投稿 効果的なフォーマット(画像、, Reels, テキスト)そして、具体的な数値に基づいて編集方針を調整する。.
よくある質問
フェイスブックでのウェブスクレイピングは合法か?
スクレイピングの合法性については依然として 法的グレーゾーン. 原則として、収集する 公開データ 法律で禁止されているわけではない。.
問題は別のところにある。利用規約では、 Meta 許可なくデータを自動収集することを明示的に禁止しています。Facebookアカウントにログインした状態でスクレイピングを行うと、明らかにその利用規約に違反することになります。.
具体的には、2つのリスクがある:その サスペンション または 解約 アカウントの停止、および民事訴訟。. Meta これまでに複数のスクレイピングサービスを相手取り訴訟を起こしており、その結果はまちまちである。.
彼女は一部の人々に対しては勝訴したが、以下に対しては敗訴した。 Bright Data 2024年:裁判所は、当時有効だった利用規約では、インターネットに接続していない状態で行われた公的データの収集は対象外であると判断し、 Meta その後、その訴えを取り下げた。.
ヨーロッパでは RGPD この方程式に加わる。あるデータは依然として 個人データ たとえ一般に公開されている情報であっても、特定の人物を識別できる場合は例外です。したがって、情報の収集を最小限に抑え、データを適切に保護し、匿名化された競合他社の動向調査や研究など、許容される範囲内の利用にとどめる必要があります。.
APIを使わずにFacebookをスクレイピングするには?
あなたは Facebook用スクラッパーをカスタマイズして作成するには Python, 、公式APIを経由せずに実現することも可能ですが、それには確かな技術力が必要です。いくつかの障害が予想されます。Facebookではしばしば 繋がり, 、ボットを検知し、自動リクエストの数を制限します。以下の対策を講じる 代理人 詰まりを防ぐためには、すぐに欠かせないものとなります。.
どの図書館が一番いいですか Python Facebookをスクレイピングするには?
デュオ Selenium (ブラウザをシミュレートするため)および BeautifulSoup (HTMLを解析するために)は、2026年9月においても、最もよく利用されている自社開発のツールの一つである。. Selenium 動的コンテンツを読み込み、, BeautifulSoup 次に、次のようなデータを抽出します。 投稿、 彼ら 好き どこ コメント.
無料のFacebookスクレイパー・ツールはありますか?
Bright Data, Octoparse と Apify いずれも以下のものを提供しています 無料体験 サブスクリプションを契約する前に、その機能を試すことができます。これらの無料版はデータ容量に制限があります。最初の試用には十分ですが、本格的に利用するにはすぐに有料プランへの切り替えが必要になります。.
Facebookのグループからデータを抽出するには?
ほとんどのスクレイピングツールでは、’公開グループからデータを抽出. 非公開グループはそのまま残る 手の届かないところ これらのツール。次のような専用のスクレイパーを使って Facebook Scraper API (Bright Data) または Facebook Groups Scraper (Apify)、手順は簡単です:
- を取得する’グループのURL お使いのブラウザから(形式: https://www.facebook.com/groups/…).
- このURLをツールに貼り付けてください。.
- 必要なフィールド(投稿、日付、反応)を設定します。.
- 抽出を実行し、結果を以下の形式でエクスポートします CSV どこ JSON.
したがって、2026年にFacebookをスクレイピングすることは依然として十分に可能です。コード不要のツールを使い始めたばかりの初心者であっても、 Octoparse, 、あるいは独自のソリューションをコーディングすることを好むベテラン開発者であっても、あなたのプロフィールやニーズに合ったアプローチがあります。.
別の方法を試してみましたか?コメント欄で体験談を共有したり、質問を投稿したりしてください。.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA