Facebook im Jahr 2026 zu scrapen, ist machbar, aber komplizierter als früher. Facebook blockiert aktiv Scraper, was spezielle Tools wie Bright Data Wo Apify weitaus zuverlässiger als eine selbst entwickelte Lösung in Python.
Hier sind die Methoden, die wirklich funktionieren, was du daraus gewinnen kannst und das Rechtsrahmen Was du wissen solltest, bevor du loslegst.

Verschiedene Methoden, um auf Facebook zu scrapen
das Web Scraping ist ein automatisierter Prozess, der Daten von Websites aus. Auf Facebook hast du zwei Hauptmöglichkeiten: Entweder nutzt du einen gebrauchsfertiges Werkzeug, oder deine eigene Lösung mithilfe von Programmierbibliotheken entwickeln. Die Wahl hängt von deinen technischen Kenntnissen und dem Datenvolumen ab, das du abrufen möchtest.
1. Web-Scraping-Tools verwenden
Scraping-Tools richten sich an diejenigen, die keine keine Programmierkenntnisse. Es handelt sich um schlüsselfertige Lösungen, die es ermöglichen,’Daten mit wenigen Klicks extrahieren. Bei Facebook stechen drei Lösungen besonders hervor: Bright Data, Apify und Octoparse.
| Werkzeug | Technisches Niveau | Was er auf Facebook scrapt | Eintrittspreis |
|---|---|---|---|
| Bright Data | Mittelstufe (API) | Seiten, Gruppen, öffentliche Beiträge, Profile | Nutzungsabhängige Preisgestaltung, kostenlose Testversion verfügbar |
| Apify | Anfänger bis Fortgeschrittene | Seiten, Beiträge, Kommentare, Reels, Marktplatz | Nutzungsabhängige Preisgestaltung, kostenlose Testversion verfügbar |
| Octoparse | Anfänger (ohne Programmierkenntnisse) | Öffentliche Daten zu Seiten und Profilen | Eingeschränkte kostenlose Version verfügbar |
Bright Data
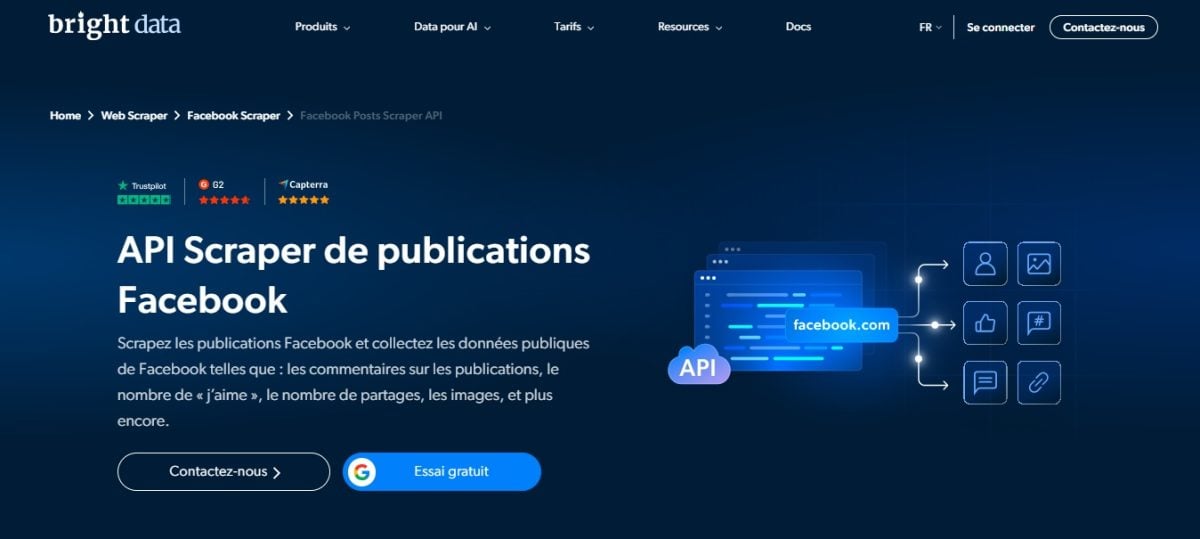
Bright Data Kombination Proxy-Netzwerk, Scraping-Browser und APIs auf einer einzigen Plattform. Die Rotation von Proxies verringert das Risiko einer Sperrung durch Facebook erheblich, was ein entscheidender Vorteil ist.
Seine Facebook Scraper API ist genau dafür gedacht: Du gibst ihm eine URL einer Seite oder einer Gruppe, und es gibt dir strukturierte Daten im Format JSON Wo CSV. Er kümmert sich eigenständig um die Umgehung von Bot-Schutzmaßnahmen und die Code-Analyse.
Entdecke unser ausführliche Rezension zu Bright Data Um noch einen Schritt weiter zu gehen.
Apify

Apify ist eine Plattform, die vorkonstruierte Lösungen genannt « Actors ".
Sein Flaggschiff-Tool, das Facebook Pages Scraper, erfasst die Informationen der öffentlichen Seiten: Name, Kategorie, Kontaktdaten, Anzahl der „Gefällt mir“-Angaben und Abonnenten sowie Bewertung.
Andere Actors richten sich an die Beiträge, Sie Kommentare, Sie Gruppen bei dem die Facebook Marketplace.
Schau dir unsere ausführliche Rezension zu Apify mehr wissen.
Octoparse
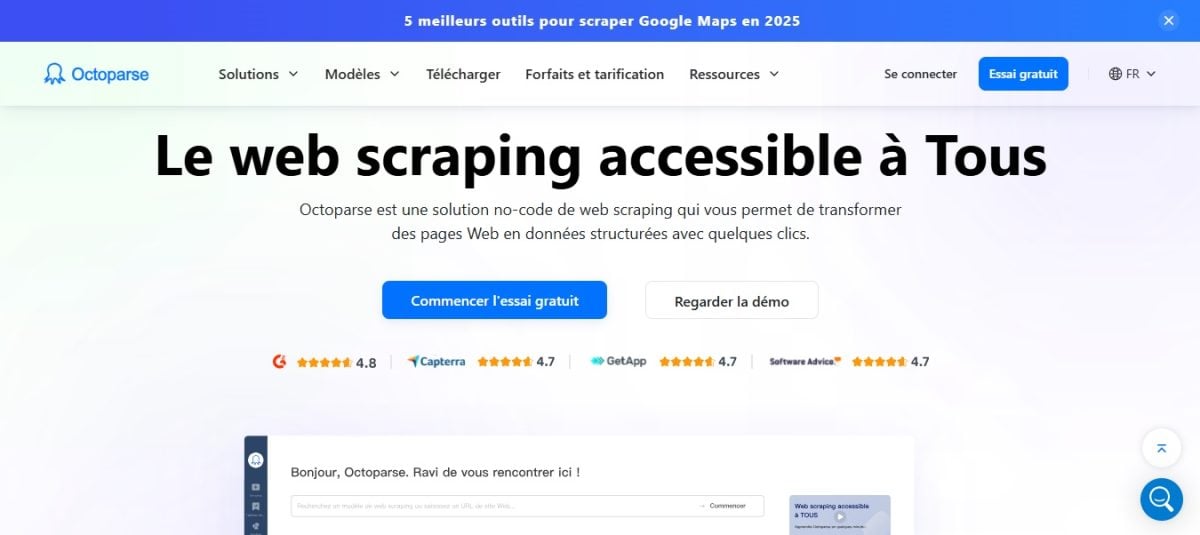
Octoparse ermöglicht es, Scraping ohne Programmierung dank einer intuitiven grafischen Benutzeroberfläche. Es gibt keine vorgefertigte Vorlage für Facebook: Man fügt die URL einer Seite oder eines Profils ein, und das Tool erkennt automatisch die Daten, und dann passt du den Workflow (Scrollen, Export) an, ohne auch nur eine einzige Zeile Code zu schreiben.
Das ist eine gute Option, wenn du keine keine technischen Fähigkeiten, vorausgesetzt, man ist bereit, sich zunächst einzuarbeiten.
In unserem erklären wir dir alle Funktionen ausführliche Rezension zu Octoparse.
2. Entscheiden Sie sich für eine selbst entwickelte Lösung mit Python
Willst du alles unter Kontrolle haben? Das kannst du. Erstelle deinen eigenen Facebook-Scraper in Python.
Der klassische Ansatz kombiniert einen automatisierter Browser und ein HTML-Analysebibliothek. Ein automatisierter Browser öffnet die Seiten so, wie es ein echter Nutzer tun würde, wodurch dynamische Interaktionen auf Facebook wie das endlose Scrollen, bei dem neue Beiträge geladen werden, verarbeitet werden können.
Konkret bedeutet das, dass der Kombination Selenium + BeautifulSoup öffnet die Facebook-Seiten so, wie es ein Mensch tun würde, wartet, bis der Inhalt geladen ist, und extrahiert die Daten anschließend in eine Datei JSON Wo CSV.
- Selenium steuert den Browser, um mit der Seite zu interagieren: klicken, scrollen, warten.
- BeautifulSoup analysiert anschließend das HTML-Code und ruft die gewünschten Informationen ab.
Hier ist ein minimalistisches Skript-Gerüst, mit dem du loslegen kannst:
from selenium import webdriver
from bs4 import BeautifulSoup

driver = webdriver.Chrome()
driver.get("https://www.facebook.com/nom-de-la-page")

soup = BeautifulSoup(driver.page_source, "html.parser")
for post in soup.find_all("div", {"role": "article"}):
    print(post.get_text())

driver.quit()
Achtung, die Realität ist härter als der Code. Facebook verlangt oft eine Verbindung, erkennt Bots und begrenzt die Anzahl automatisierter Anfragen. Ohne Proxies Ohne Rotation und CAPTCHA-Handhabung wird dein selbst entwickelter Scraper schnell blockiert. Hier haben spezielle Tools wieder die Nase vorn.
Was kann man auf Facebook scrapen?
Mit Facebook-Scraping kannst du ausschließlich öffentliche Daten. Folgende Arten von Inhalten sind verfügbar:
- Öffentliche Seiten : Seitenname, Anzahl der likes und Abonnenten, Text der Beiträge, Bemerkungen, Likes und Kommentare.
- Öffentliche Gruppen : Name der Gruppe, Beschreibung, Anzahl der Mitglieder und Veröffentlichungen, die auch ohne Mitgliedschaft einsehbar sind.
- Öffentliche Profile : Name, Profilbild und – je nach den Einstellungen der jeweiligen Person – Biografie, Wohnort und öffentliche Beiträge.
- Veranstaltungen und Reels : Titel, Datum, Ort und Einsatzstatistiken sind öffentlich einsehbar.
Spezielle Scraper extrahieren diese Elemente und liefern sie dir in einem strukturierten Format (CSV Wo JSON), die du direkt für deine Analysen nutzen kannst. Ein typisches Ergebnis enthält die ID des Beitrags, den Text, das Datum und die Anzahl der likes, die Reaktionen und die Bemerkungen.
Persönliche Daten wie beispielsweise nachrichten, Sie geschlossene Gruppen bei dem die gesperrte Profile liegen außerhalb des Anwendungsbereichs der hier vorgestellten Tools, die sich auf öffentlich zugängliche Daten beschränken. Der Versuch, über ein angemeldetes Konto darauf zuzugreifen, würde gegen die Nutzungsbedingungen von Meta und würde ein echtes Problem hinsichtlich des Datenschutzes darstellen.
Wie funktioniert Web-Scraping auf Facebook im Jahr 2026?
Mit einem speziellen Tool wie Bright Data Wo Apify, Ein Facebook-Scraping-Projekt läuft in vier Schritten ab.
1. Wähle den richtigen Scraper entsprechend deiner Zielgruppe aus
Bestimme zunächst, welche Daten du extrahieren möchtest. Scraper sind oft auf bestimmte Inhaltstypen spezialisiert:
- Facebook Posts Scraper : ruft die Veröffentlichungen einer Seite (Text, Datum, Likes, Reaktionen, Anzahl der Kommentare).
- Facebook Pages Scraper : extrahiert die Informationen einer Unternehmensseite (Name, Kategorie, Adresse, Bewertungen).
- Facebook Profile Scraper : erfasst die Daten eines Profil öffentlich.
- Facebook Groups Scraper : konzentriert sich auf die Beiträge und Diskussionen einer Gruppe.
An Apify, wählst du den Schauspieler im Menü aus. Auf Bright Data, wähle den Facebook Scraper API das deinem Ziel entspricht.
2. Geben Sie die URL der Seite oder der Gruppe ein
Das Tool benötigt die’Genaue URL deines Ziels auf facebook.com. Kopiere sie direkt aus der Adressleiste deines Browsers:
- Für eine Seite: https://www.facebook.com/nomdelapage
- Für eine Gruppe: Öffne die Gruppe, klicke auf ihren Namen und kopiere dann den Link vom Typ https://www.facebook.com/groups/id
Anschließend passt die Optionen : Anzahl der Beiträge abzurufen, Datumsbereich, Einbeziehung von Bemerkungen und Reaktionen. Je mehr du den Umfang einschränkst, desto schneller erfolgt die Extraktion.
3. Die Datenerhebung starten
Klicke auf Start zum Einstieg. Das Tool kümmert sich selbst um die technischen Aspekte: Drehung der Proxies, Umgehung der Anti-Scraping-Erkennung und Umgang mit den von Facebook auferlegten Beschränkungen. Genau hier macht ein spezieller Scraper den Unterschied zu einer selbst entwickelten Lösung aus.
Die Bearbeitungszeit hängt vom Umfang ab: ein paar Sekunden für eine Handvoll Veröffentlichungen, mehrere Minuten bei einem umfangreichen Verlauf.
4. Die Daten im richtigen Format exportieren
Sobald die Datenerfassung abgeschlossen ist, exportierst du alles mit einem Klick. Wähle das Format entsprechend deinem Verwendungszweck aus:
- CSV Wo Excel : ideal zum Sortieren und Auswerten in einer Tabellenkalkulation.
- JSON : Ideal, wenn du die Daten wieder in deinen eigenen Code oder in eine Datenbank einspeisen möchtest.
Ein typisches Ergebnis enthält die Kennung des Post, der Text, das Veröffentlichungsdatum, die Anzahl der likes, die Reaktionen und die Bemerkungen. Du erhältst eine übersichtliche Struktur, die du direkt nutzen kannst.
Warum sollte man auf Facebook scrapen?
Durch Scraping erhältst du Zugriff auf öffentliche Daten die du nicht manuell aus Tausenden von Veröffentlichungen sammeln könntest. Hier sind die häufigsten und legitimsten Anwendungsfälle:
- Wettbewerbsanalyse: du behältst die im Auge Facebook-Seiten deiner Mitbewerber, um deren Content-Strategie zu analysieren. Du findest heraus, welche Formate Beiträge erzeugen das größte Engagement, ohne dass man stundenlang alles manuell erfassen muss.
- Marktbeobachtung und Stimmungsanalyse: die … sammeln Beiträge und das Bemerkungen Anhand einer Marke oder einer Veranstaltung kannst du die allgemeine Meinung einschätzen und die Entwicklung einer Kampagne im Laufe der Zeit verfolgen.
- Akademische und wissenschaftliche Forschung: Forscher nutzen Facebook-Daten für groß angelegte soziologische oder linguistische Studien, um die Verbreitung von Informationen oder die Entwicklung des Wortschatzes zu beobachten.
- Analyse der Content-Performance: Wenn du mehrere Seiten verwaltest, vergleichst du deine eigenen Beiträge um herauszufinden, welche Formate funktionieren (Bild, Reels, Text) und passe deine redaktionelle Ausrichtung an konkrete Zahlen an.
Häufig gestellte Fragen
Ist es legal, auf Facebook Web Scraping zu betreiben?
Die Rechtmäßigkeit des Scrapings bleibt ein rechtliche Grauzone. Grundsätzlich gilt: Das Sammeln von öffentliche Daten ist gesetzlich nicht verboten.
Das Problem liegt woanders: Die Nutzungsbedingungen von Meta verbieten ausdrücklich die automatisierte Datenerfassung ohne Genehmigung. Wenn du also beim Scraping in deinem Facebook-Konto angemeldet bist, verstößt du eindeutig gegen die Nutzungsbedingungen von Facebook.
Konkret riskierst du zwei Dinge: die Aufhängung oder der Kündigung deines Kontos sowie zivilrechtliche Schritte. Meta hat bereits mehrere Scraping-Dienste vor Gericht verklagt, mit unterschiedlichem Erfolg.
Sie hat gegen einige Recht bekommen, hat aber gegen Bright Data im Jahr 2024: Das Gericht entschied, dass die damals geltenden Nutzungsbedingungen die Erhebung öffentlicher Daten im Offline-Modus nicht abdeckten, und Meta hat daraufhin seine Klage zurückgezogen.
In Europa ist der DSGVO kommt noch hinzu. Eine Angabe bleibt eine personenbezogene Daten selbst wenn sie öffentlich zugänglich ist, sobald sie eine Person identifiziert. Du musst daher die Datenerhebung auf ein Minimum beschränken, die Daten sichern und dich an zulässige Verwendungszwecke wie anonymisierte Wettbewerbsbeobachtung oder Recherche halten.
Wie kann man Facebook scrapen, ohne die API zu verwenden?
Du kannst einen maßgeschneiderten Facebook-Scraper erstellen in Python, ohne eine offizielle API zu nutzen, doch dafür sind fundierte technische Kenntnisse erforderlich. Rechne mit einigen Hindernissen: Facebook verlangt oft eine Verbindung, erkennt Bots und begrenzt die Anzahl automatisierter Anfragen. Vorsehen von Proxies wird schnell unverzichtbar, um ein Blockieren zu vermeiden.
Welche Bibliothek ist die beste? Python um Facebook zu scrapen?
Das Duo Selenium (um einen Browser zu simulieren) und BeautifulSoup (zur Analyse von HTML) ist im September 2026 nach wie vor eine der am häufigsten genutzten hauseigenen Optionen. Selenium lädt den dynamischen Inhalt, BeautifulSoup extrahiert anschließend Daten wie die Beiträge, Sie likes bei dem die Bemerkungen.
Gibt es kostenlose Tools, um Facebook zu scrapen?
Bright Data, Octoparse und Apify bieten alle kostenlose Probeaufnahmen um deren Funktionen zu testen, bevor sie ein Abonnement abschließen. Diese kostenlosen Versionen sind hinsichtlich des Datenvolumens begrenzt: Sie reichen für einen ersten Test aus, doch für eine ernsthafte Nutzung ist schnell ein kostenpflichtiges Angebot erforderlich.
Wie kann man Daten aus Facebook-Gruppen extrahieren?
Mit den meisten Scraping-Tools lässt sich’Daten aus öffentlichen Gruppen extrahieren. Die privaten Gruppen bleiben bestehen außer Reichweite dieser Tools. Mit speziellen Scrapern wie Facebook Scraper API (Bright Data) oder Facebook Groups Scraper (Apify), ist die Vorgehensweise ganz einfach:
- Ruft die’URL der Gruppe über deinen Browser (Format: https://www.facebook.com/groups/…).
- Füge diese URL in das Tool ein.
- Konfiguriere die gewünschten Felder: Beiträge, Daten, Reaktionen.
- Starte die Extraktion und exportiere das Ergebnis in CSV Wo JSON.
Ein Facebook-Scraper wird also auch im Jahr 2026 noch durchaus möglich sein. Egal, ob du Anfänger bist und ein Tool ohne Programmierung nutzt wie Octoparse, oder als erfahrener Entwickler, der seine Lösung lieber selbst programmiert – es gibt einen Ansatz, der genau zu deinem Profil und deinen Bedürfnissen passt.
Hast du eine andere Methode ausprobiert? Teile deine Erfahrungen mit oder stelle deine Fragen in den Kommentaren.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA