Fazer scraping no Facebook em 2026 é possível, mas mais complicado do que antes. O Facebook bloqueia ativamente os scrapers, o que torna as ferramentas específicas, como Bright Data Onde Apify muito mais fiáveis do que uma solução caseira em Python.
Eis os métodos que realmente funcionam, o que podes extrair e o quadro jurídico o que deves saber antes de começares.

Os diferentes métodos de recolha de dados no Facebook
a raspagem da web é um processo automatizado que extrai dados a partir de sites. No Facebook, tens duas opções principais: utilizar um ferramenta pronta a usar, ou desenvolver a tua própria solução com bibliotecas de programação. A escolha depende do teu nível técnico e do volume de dados que pretendes recuperar.
1. Utilizar ferramentas de recolha de dados da Web
As ferramentas de scraping destinam-se a quem não tem sem conhecimentos de programação. Trata-se de soluções chave na mão que permitem’extrair dados com apenas alguns cliques. No que diz respeito ao Facebook, destacam-se três soluções: Bright Data, Apify e Octoparse.
| Ferramenta | Nível técnico | O que ele extrai do Facebook | Preço do bilhete de entrada |
|---|---|---|---|
| Bright Data | Intermédio (API) | Páginas, grupos, publicações públicas, perfis | Tarifação por utilização, com período de teste gratuito disponível |
| Apify | Nível iniciante a intermédio | Páginas, publicações, comentários, Reels, Marketplace | Tarifação por utilização, com período de teste gratuito disponível |
| Octoparse | Principiante (sem código) | Dados públicos de páginas e perfis | Está disponível uma versão gratuita limitada |
Bright Data
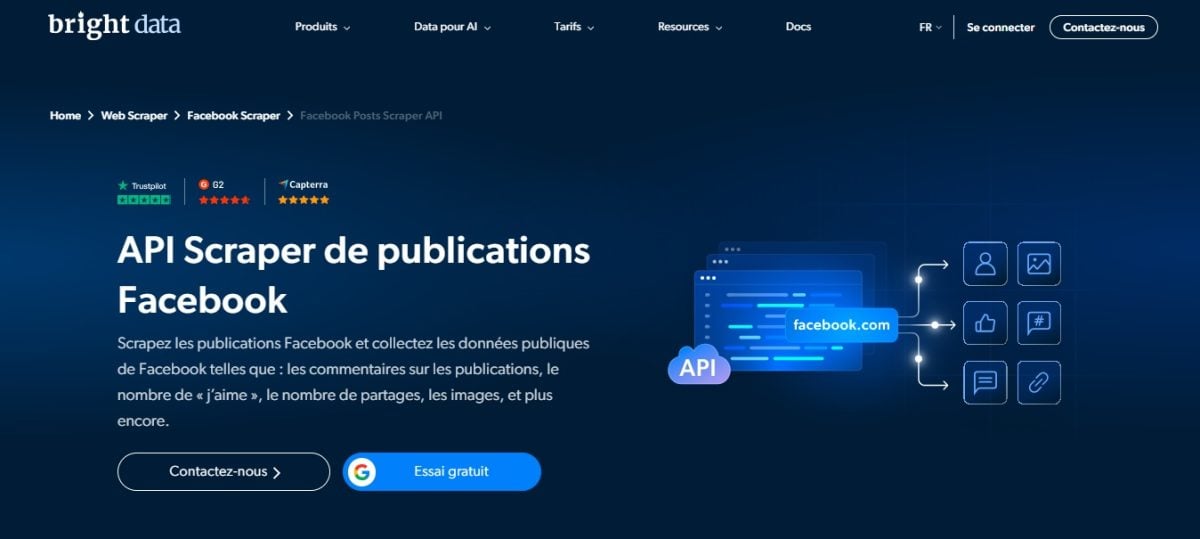
Bright Data combina rede de proxies, navegador de raspagem e API numa única plataforma. A rotação de proxies reduz significativamente o risco de bloqueio pelo Facebook, o que constitui uma vantagem decisiva.
Dele Facebook Scraper API foi concebido para isso: basta dar-lhe uma URL de página ou de grupo, e apresenta-te dados estruturados no formato JSON Onde CSV. É ele próprio que gere a contornagem das proteções anti-bot e a análise do código.
Descobre o nosso crítica completa sobre Bright Data para saber mais.
Apify

Apify é uma plataforma que oferece soluções pré-construídas denominadas « Actors ".
A sua ferramenta principal, o Facebook Pages Scraper, recolhe as informações das páginas públicas: nome, categoria, dados de contacto, número de «gostos» e de seguidores, classificação.
outros Actors visam os publicações, eles comentários, eles grupos onde o Facebook Marketplace.
Consulta o nosso crítica completa sobre Apify Para saber mais.
Octoparse
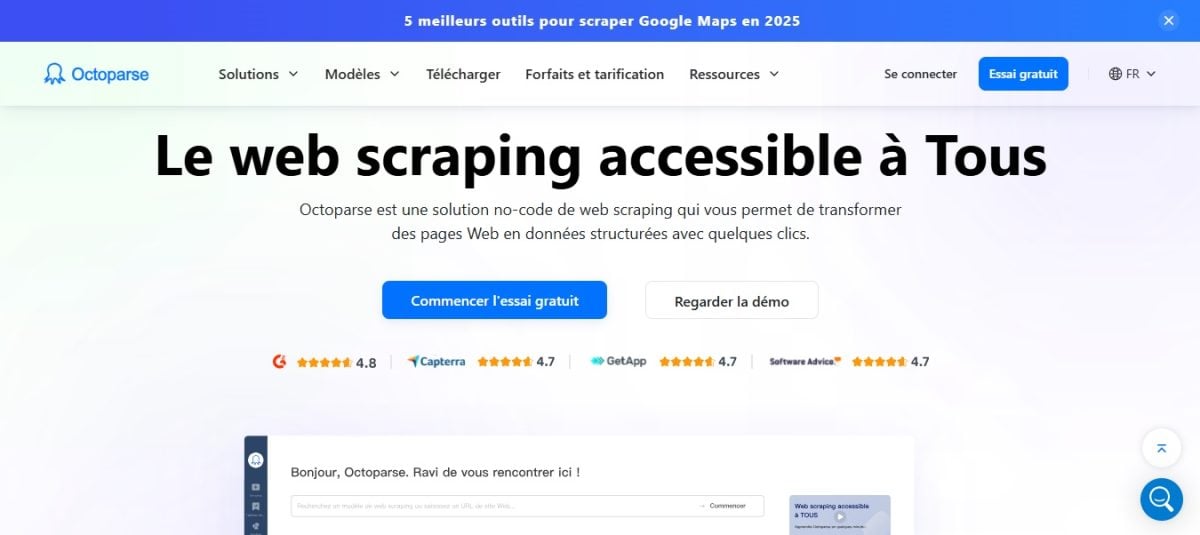
Octoparse permite fazer scraping sem código graças a uma interface visual intuitiva. Não disponibiliza modelos prontos a usar para o Facebook: basta colar o URL de uma página ou de um perfil, e a ferramenta deteta automaticamente os dados e, em seguida, ajustas o fluxo de trabalho (navegação, exportação) sem escrever uma única linha de código.
É uma boa opção se não tiveres sem competências técnicas, desde que se esteja disposto a dedicar algum tempo à aprendizagem.
Explicamos-te todas as funcionalidades no nosso crítica completa sobre Octoparse.
2. Optar por uma solução caseira com Python
Queres controlar tudo? Podes Cria o teu próprio scraper do Facebook dentro Python.
A abordagem clássica combina um navegador automatizado e um Biblioteca de análise HTML. Um navegador automatizado abre as páginas tal como um utilizador real faria, o que permite gerir as interações dinâmicas do Facebook, como a rolagem infinita que carrega novas publicações.
Na prática, o combo Selenium + BeautifulSoup abre as páginas do Facebook tal como um ser humano faria, aguarda que o conteúdo seja carregado e, em seguida, extrai os dados para um ficheiro JSON Onde CSV.
- Selenium controla o navegador para interagir com a página: clicar, percorrer, aguardar.
- BeautifulSoup analisa, em seguida, o código HTML e obtém as informações pretendidas.
Aqui está um esboço de script mínimo para começares:
from selenium import webdriver
from bs4 import BeautifulSoup

driver = webdriver.Chrome()
driver.get("https://www.facebook.com/nom-de-la-page")

soup = BeautifulSoup(driver.page_source, "html.parser")
for post in soup.find_all("div", {"role": "article"}):
    print(post.get_text())

driver.quit()
Atenção, a realidade é mais dura do que o código. O Facebook exige frequentemente uma conexão, deteta os bots e limita o número de pedidos automatizados. Sem proxies Sem rotadores nem gestão de CAPTCHAs, o teu scraper caseiro será rapidamente bloqueado. É aí que as ferramentas especializadas ganham vantagem.
O que é que se pode recolher no Facebook?
O scraping no Facebook permite-te recuperar apenas dados públicos. Eis os tipos de conteúdos disponíveis:
- Páginas públicas : nome da página, número de gostos e de assinantes, texto das Postagens, comentários, partilhas e reações.
- Grupos públicos : nome do grupo, descrição, número de membros e publicações visíveis sem ser membro.
- Perfis públicos : nome, foto de perfil e, dependendo das definições da pessoa, biografia, cidade e publicações públicas.
- Eventos e Reels : título, data, local e estatísticas de participação visíveis ao público.
Os scrapers especializados recolhem esses elementos e apresentam-nos num formato estruturado (CSV Onde JSON), que podes utilizar diretamente nas tuas análises. Um resultado típico inclui o identificador da publicação, o texto, a data, o número de gostos, as reações e as comentários.
As informações privadas, tais como as mensagens, eles grupos fechados onde o perfis bloqueados ficam fora do âmbito das ferramentas aqui apresentadas, que se limitam aos dados públicos. Tentar aceder a esses dados através de uma conta com sessão iniciada violaria os Termos e Condições de Utilização de Meta e colocaria um verdadeiro problema no que diz respeito ao respeito pelos dados pessoais.
Como fazer web scraping no Facebook em 2026?
Com uma ferramenta específica como Bright Data Onde Apify, um projeto de scraping do Facebook decorre em quatro etapas.
1. Escolher o scraper adequado de acordo com o teu público-alvo
Começa por identificar o que pretendes extrair. Os scrapers são frequentemente especializados por tipo de conteúdo:
- Facebook Posts Scraper : recupera os publicações de uma página (texto, data, «gostos», reações, número de comentários).
- Facebook Pages Scraper : extraia as informações de uma página de empresa (nome, categoria, morada, avaliações).
- Facebook Profile Scraper : recolhe os dados de um perfil público.
- Facebook Groups Scraper : foca-se nas publicações e discussões de um grupo.
Sobre Apify, escolhes o ator na loja. Em Bright Data, seleciona o Facebook Scraper API que corresponda ao teu alvo.
2. Introduzir o URL da página ou do grupo
A ferramenta necessita do’URL exata do teu alvo em facebook.com. Copia-a diretamente da barra de endereços do teu navegador:
- Para uma página: https://www.facebook.com/nomdelapage
- Para um grupo: abre o grupo, clica no nome dele e, em seguida, copia o link do tipo https://www.facebook.com/groups/id
Em seguida, ajusta os opções : número de Postagens a recuperar, intervalo de datas, inclusão de comentários e reacções. Quanto mais restringires o âmbito, mais rápida será a extração.
3. Iniciar a recolha de dados
Clique em Início para começar. A ferramenta trata sozinha das questões técnicas: rotação das proxies, contornar a deteção anti-scraping e gerir as limitações impostas pelo Facebook. É precisamente aí que um scraper dedicado faz a diferença em relação a uma solução desenvolvida internamente.
O tempo de processamento depende do volume: alguns segundos para um punhado de publicações, vários minutos para um histórico extenso.
4. Exportar os dados no formato adequado
Assim que a recolha estiver concluída, podes exportar tudo com um clique. Escolhe o formato de acordo com a tua necessidade:
- CSV Onde Excel : ideal para ordenar e analisar numa folha de cálculo.
- JSON : perfeito se quiseres reintroduzir os dados no teu próprio código ou numa base de dados.
Um resultado típico contém o identificador do publicar, o texto, a data de publicação, o número de gostos, as reações e as comentários. Fica-se com uma estrutura organizada, pronta a ser utilizada.
Porquê fazer scrap no Facebook?
O scraping dá-te acesso a dados públicos que não conseguirias recolher manualmente em milhares de publicações. Eis os casos de utilização mais comuns e legítimos:
- Análise da concorrência: tu ficas de olho nos páginas do Facebook dos teus concorrentes para analisar a estratégia de conteúdo deles. Identifica quais os formatos de Postagens geram maior envolvimento, sem ter de passar horas a registar tudo manualmente.
- Monitorização e análise de sentimentos: recolher os Postagens e a comentários A análise em torno de uma marca ou de um evento permite-te avaliar a opinião geral e acompanhar a evolução de uma campanha ao longo do tempo.
- Investigação académica e científica: Os investigadores utilizam os dados do Facebook para estudos sociológicos ou linguísticos em grande escala, com o objetivo de observar a difusão de uma informação ou a evolução de um vocabulário.
- Análise do desempenho do conteúdo: Se gerires várias páginas, compara as tuas próprias Postagens para identificar os formatos que funcionam (imagem, Reels, texto) e adaptar a tua linha editorial com base em números concretos.
Perguntas frequentes
É legal fazer web scrap no Facebook?
A legalidade do scraping continua a ser uma zona jurídica cinzenta. Em princípio, recolher dados públicos não é proibido por lei.
O problema reside noutro aspeto: as condições de utilização de Meta proíbem explicitamente a recolha automatizada de dados sem autorização. Se fizeres «scraping» enquanto estiveres ligado à tua conta do Facebook, estás, portanto, a infringir claramente os seus Termos de Utilização.
Na prática, corres o risco de duas coisas: a suspensão ou o rescisão da tua conta e de ações cíveis. Meta já intentou várias ações judiciais contra serviços de scraping, com resultados variáveis.
Ela saiu vencedora contra alguns, mas perdeu contra Bright Data em 2024: o tribunal considerou que os seus Termos e Condições de Utilização, então em vigor, não abrangiam a recolha de dados públicos efetuada sem estar ligado à Internet, e Meta desistiu posteriormente das suas ações judiciais.
Na Europa, o RGPD junta-se à equação. Um dado continua a ser um dados pessoais mesmo quando é acessível ao público, desde que permita identificar alguém. Por isso, deves minimizar a recolha de dados, protegê-los e limitar-te a utilizações aceitáveis, como a análise da concorrência de forma anónima ou a investigação.
Como é que posso recolher dados do Facebook sem utilizar a API?
Pode criar um scraper personalizado do Facebook em Python, sem recorrer a uma API oficial, mas isso requer competências técnicas reais. Prepara-te para vários obstáculos: o Facebook exige frequentemente uma conexão, deteta os robôs e limita o número de pedidos automatizados. Prever proxies torna-se rapidamente indispensável para evitar o bloqueio.
Qual é a melhor biblioteca? Python para fazer scraping no Facebook?
O duo Selenium (para simular um navegador) e BeautifulSoup (para analisar o HTML) continua a ser uma das opções mais utilizadas em setembro de 2026. Selenium carrega o conteúdo dinâmico, BeautifulSoup em seguida, extrai os dados, tais como os Postagens, eles gostos onde o comentários.
Existem ferramentas gratuitas de recolha de dados do Facebook?
Bright Data, Octoparse e Apify todos oferecem testes gratuitos para testarem as suas funcionalidades antes de subscreverem um plano. Estas versões gratuitas têm um limite de volume de dados: são suficientes para um primeiro teste, mas uma utilização mais intensiva exige rapidamente a adesão a um plano pago.
Como é que posso extrair dados de grupos do Facebook?
A maioria das ferramentas de scraping permite’extrair dados de grupos públicos. Os grupos privados continuam a existir fora do alcance dessas ferramentas. Com scrapers específicos como Facebook Scraper API (Bright Data) ou Facebook Groups Scraper (Apify), o procedimento a seguir é simples:
- Recupera o’URL do grupo a partir do teu navegador (formato: https://www.facebook.com/groups/…).
- Cola esta URL na ferramenta.
- Configure os campos pretendidos: publicações, datas, reações.
- Inicia a extração e exporta o resultado para CSV Onde JSON.
O scraping do Facebook em 2026 continua, portanto, a ser perfeitamente possível. Quer sejas um principiante a utilizar uma ferramenta sem código como Octoparse, quer sejas um programador experiente que prefere programar a tua própria solução, existe uma abordagem adequada ao teu perfil e às tuas necessidades.
Já experimentaste outro método? Partilha a tua experiência ou faz as tuas perguntas nos comentários.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA